
REST et GraphQL
Toute méthode, en-têtes personnalisés, un corps et une authentification - et des règles sur le JSON qui revient.
Surveillance d’API
L’outil de monitoring d’API de HostTracker vérifie la disponibilité, le temps de réponse et la charge utile de vos endpoints depuis 300+ emplacements, selon des règles que vous écrivez en langage clair - un code de statut, un champ JSON, un temps de réponse - et vous alerte dès qu’un appel ne les respecte plus.
Comment fonctionne un contrôle API
Les règles lisent la réponse et comparent. Ensemble, ces quatre lignes couvrent les couches qui comptent.
api.example.com/v1/orders · 4 règles · réussi
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Requêtes structurées dans du JSON, XML, HTML ou YAML ; la chaîne de redirections saut par saut ; le protocole TLS négocié et le chiffrement.
Comparez cette exécution avec la précédente : un compteur qui ne recule jamais, un hachage de corps qui ne doit pas changer.
JSONPath, XPath ou une expression régulière extrait une valeur ; égal, plage, appartenance à une liste ou null décide.
En savoir plusLa requête façonnée comme le point de terminaison l'attend, les règles sur ce qui revient.
Toute méthode, en-têtes personnalisés, un corps et une authentification - et des règles sur le JSON qui revient.
Analysez le corps en XML et sélectionnez avec XPath. L'enveloppe n'est qu'une réponse de plus.
Envoyez une charge utile selon un planning et vérifiez l'accusé de réception, afin qu'un récepteur silencieux soit détecté avant qu'un partenaire ne le remarque.
HostTracker vérifie vos endpoints d’API selon un planning, en validant le code de statut, le type de contenu et les valeurs à l’intérieur de la réponse - pas seulement le fait que le serveur réponde.
Surveiller vos API est réellement essentiel. Cela permet de suivre leur performance, leur disponibilité, et de vérifier qu’elles font bien ce qu’elles sont censées faire. Cela garantit aussi le respect des standards de performance, ce qui aide à éviter d’éventuels problèmes.
La surveillance de la disponibilité consiste essentiellement à vérifier un endpoint d’API à intervalles réguliers pour s’assurer qu’il est présent quand vous en avez besoin et qu’il fonctionne bien. La surveillance de la performance mesure quant à elle la vitesse et la fiabilité avec lesquelles une API répond aux requêtes.
Le bon fonctionnement des API peut avoir un impact important sur l’expérience des utilisateurs, sur le fonctionnement global des applications, et même sur le chiffre d’affaires de l’entreprise.
La valeur extraite par une règle est stockée à chaque contrôle et tracée à côté du temps de réponse et de la vitesse.
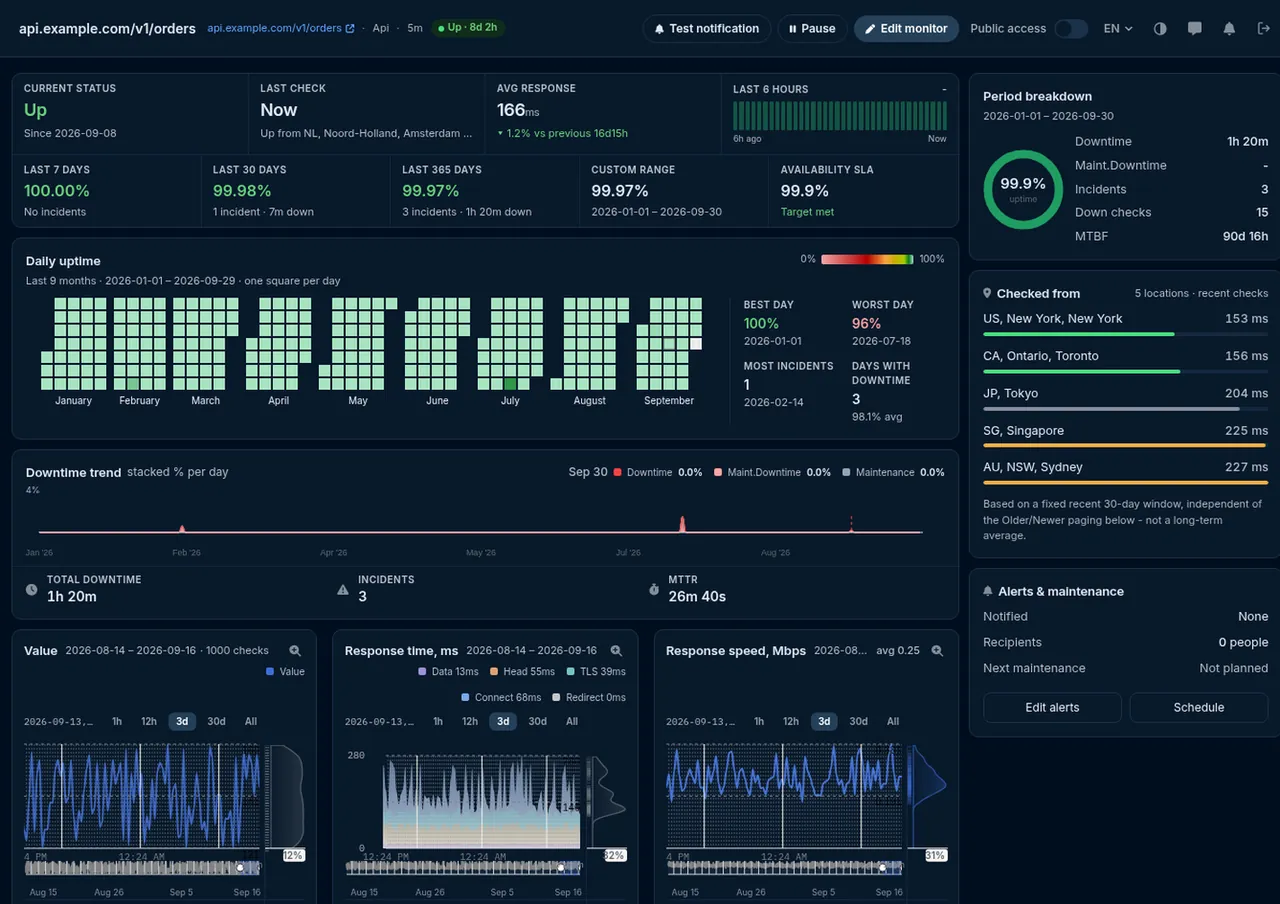
body.json.path("$.count") devient une série. Une chute à zéro est visible avant de devenir une alerte.
Temps de connexion, TLS, en-tête et données par contrôle, depuis chaque emplacement que vous avez choisi.
Sites web, serveurs, API, certificats. Un type de vérification par page, avec les mêmes emplacements, alertes et rapports derrière.
"Je travaille avec ce service de surveillance depuis longtemps, et ma routine quotidienne n’est plus un problème. Il surveille silencieusement tous mes sites et me permet de réagir dès que quelque chose ne va pas."
Adopté par des équipes chez
Chaque chapitre s'ouvre sur place, pour que la page reste courte.
La surveillance d’API REST ressemble superficiellement à la surveillance de disponibilité, mais c’est un métier différent. Une API est consommée par du code, pas par des personnes, et le code est intransigeant d’une façon qu’un navigateur ne l’est pas. Un visiteur humain tolère une page qui s’affiche un peu de travers ; une intégration qui reçoit un champ du mauvais type casse tout simplement. La surveillance d’API doit donc vérifier plus de couches que « le serveur a-t-il répondu », et HostTracker les vérifie dans l’ordre, en échouant à la première qui ne tient pas.
| Couche | Ce qui est vérifié | La panne qu’elle détecte |
|---|---|---|
| 1 · Joignabilité | Le DNS se résout, la connexion TCP s’ouvre, la poignée de main TLS se termine | L’endpoint a disparu, le certificat a expiré, l’hôte n’est pas routable depuis une partie du monde |
| 2 · Statut | Le code de statut HTTP, comparé aux codes que vous acceptez ou traitez explicitement comme des erreurs | Une 500 après un déploiement, une 401 due à un identifiant expiré, une 429 inattendue |
| 3 · Chronométrage | Le temps de réponse total, et sa décomposition entre connexion, TLS, en-têtes et corps | Un endpoint qui fonctionne toujours mais qui est discrètement passé de 200 ms à quatre secondes |
| 4 · Forme | Le type de contenu et les en-têtes - s’agit-il vraiment de JSON, ou d’une page d’erreur HTML déguisée en 200 | Une page d’erreur ou une redirection de connexion servie là où un payload est attendu. La panne d’API silencieuse classique |
| 5 · Contenu | Une valeur extraite du payload, ou des assertions libres sur l’ensemble de la réponse | Un champ manquant après un changement de schéma, un ensemble de résultats vide, une chaîne de version revenue en arrière, un membre d’erreur apparaissant dans une réponse censée réussir |
Les couches un à trois sont ce que fournit une vérification de disponibilité ordinaire. Les couches quatre et cinq sont ce qui en fait de la surveillance d’API - et ce sont les couches où vivent réellement la plupart des incidents d’API.
Avant que quoi que ce soit puisse être validé, le moniteur doit effectuer la requête que votre API attend. La surface de requête complète est disponible sur un moniteur d’API :
| Paramètre | Ce que vous pouvez en faire |
|---|---|
| Méthode HTTP | GET, HEAD, POST, PUT, PATCH ou DELETE |
| En-têtes personnalisés | Toute paire nom/valeur dont vous avez besoin - un jeton bearer, une clé d’API, un identifiant de tenant, un en-tête de version Accept. Les en-têtes ne sont transférés qu’au même hôte lors d’une redirection, si bien qu’un identifiant ne fuite jamais vers un tiers vers lequel votre endpoint redirige. |
| Corps de la requête | Un corps brut pour POST, PUT et PATCH, ou des paramètres encodés en formulaire |
| Authentification HTTP | Un nom d’utilisateur et un mot de passe, avec le schéma demandé par le serveur négocié sur la connexion |
| Redirections | Les suivre ou non, plafonner le nombre suivi, ou traiter toute redirection comme un échec - utile pour un endpoint qui doit répondre directement |
| Délai d’expiration | Jusqu’à 100 secondes, 40 par défaut - et un dépassement de délai est un échec de la vérification, exactement ce que vous voulez pour un endpoint sous SLA |
| Plafond de taille de réponse | 1 Mo par défaut, ajustable, afin qu’une réponse démesurée ne monopolise pas la vérification |
| Codes de statut acceptés et rejetés | Des listes de codes à ignorer, et de codes à traiter comme des erreurs - l’outil adapté à un endpoint qui répond légitimement 401 ou 404 dans le cadre de son contrat |
| Contrôle DNS | Résoudre via des résolveurs spécifiques, contourner le cache DNS du point de contrôle, et vérifier vers quelles adresses IP l’hôte se résout |
| Rigueur TLS | Activez si besoin l’exigence d’une chaîne de certificat valide, de TLS 1.2 ou supérieur, de chiffrements au-dessus de 128 bits, et d’une vérification de révocation - plus la surveillance de l’expiration du certificat sur la même connexion |
La façon la plus expressive de valider une réponse consiste à écrire des règles pour elle. Chaque règle tient sur une ligne, les règles se combinent avec ET, et un moniteur peut en porter jusqu’à vingt. Voici le socle de départ vérifié pour une API JSON :
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Quatre lignes, qui couvrent à elles quatre les couches qui comptent : l’endpoint a répondu avec un
2xx, il a répondu en JSON plutôt qu’avec une page d’erreur, le payload contient un vrai résultat
plutôt qu’un résultat vide, et tout cela dans le budget de temps imparti. Parmi les règles utiles
individuellement issues du même catalogue : body.json.path("$.status") eq "ok" pour le
verdict de santé propre à une API, body.json.path("$.error") absent pour un membre
d’erreur apparaissant dans une réponse par ailleurs réussie, body.json.path("$.version") eq
"2.4.1" pour détecter un retour en arrière involontaire, redirects.count eq 0 pour
un endpoint qui doit répondre directement, et cert.days.left gt 14 pour le certificat sur
la même connexion.
Les règles lisent des sujets dans la réponse et les comparent. Ces sujets couvrent le code de statut ;
le temps de réponse total et ses composantes connexion, TLS, DNS, en-têtes et corps ; le corps brut
ainsi que sa taille et un hachage de celui-ci ; des requêtes structurées dans le payload en JSON, XML,
HTML ou YAML ; les en-têtes de réponse pris individuellement ; l’URL finale et l’URL d’origine et leurs
composantes ; la chaîne de redirection, saut par saut ; les jours restants du certificat, son émetteur
et ses noms ; le protocole TLS et le chiffrement négociés ; les adresses renvoyées par le DNS ; et
Set-Cookie. Les comparaisons vont de l’évident - égal, inférieur à, supérieur à - jusqu’à
contains, startsWith, endsWith, matches pour une
expression régulière, containsAny et containsAll pour un ensemble,
in pour une liste de valeurs acceptables, et exists, isNumber et
unique.
Il existe aussi un axe de détection de changement : une règle peut comparer la valeur de cette exécution à celle de la précédente, ce qui permet de vérifier qu’un compteur ne recule jamais ou qu’un hachage du corps n’a pas changé - le type de règle qui détecte un retour en arrière silencieux ou une modification de contenu non autorisée, plutôt qu’une panne.
À côté du langage de règles existe un chemin plus simple, à valeur unique, présent depuis longtemps dans la surveillance d’API ici et qui suffit souvent à une vérification. Vous indiquez au moniteur comment analyser le corps, comment y sélectionner une valeur, et ce que cette valeur doit être :
Le prédicat appliqué à la valeur sélectionnée couvre égal et différent, inférieur et supérieur sous forme stricte ou inclusive, l’appartenance à une liste de valeurs acceptables ou son exclusion, l’appartenance à une plage numérique ou son exclusion, et un test pour vérifier que la valeur est nulle ou totalement absente.
Un sélecteur mal formé est rejeté à l’enregistrement, pas à trois heures du matin. Le sélecteur est compilé au moment de la validation, si bien qu’une faute de frappe dans un JSONPath ou un XPath est une erreur sur le formulaire, plutôt qu’un moniteur qui échoue silencieusement - ou réussit silencieusement - depuis sa création.
Chaque panne de ce tableau renvoie un HTTP 200. C’est là tout le problème de surveiller une API sur son seul code de statut : le transport a réussi, donc le transport rapporte un succès.
| Ce qui a mal tourné | À quoi ressemble la réponse | Ce qui le détecte |
|---|---|---|
| Une page d’erreur est servie là où un payload est attendu | 200, avec du HTML | Une assertion de type de contenu, ou une règle vérifiant que le corps s’analyse comme du JSON |
| L’index de recherche a cessé de se reconstruire | 200, avec un tableau de résultats vide | Une règle vérifiant que le nombre de résultats est au moins un |
| Un champ a été renommé lors d’un changement de schéma | 200, JSON valide, membre manquant | Une règle vérifiant que le champ existe |
| Un déploiement a été annulé sans que personne ne le remarque | 200, chaîne de version plus ancienne | Une règle fixant le champ de version |
| Un membre d’erreur apparaît dans une enveloppe de succès | 200, avec un membre d’erreur renseigné | Une règle vérifiant que le membre d’erreur est absent |
| Une dépendance en aval est en panne et l’API se dégrade avec élégance | 200, avec des données partielles ou périmées | Une règle sur le champ de santé propre à l’API, ou une valeur de fraîcheur dans le payload |
| L’endpoint répond désormais en quatre secondes au lieu de deux cents millisecondes | 200, finalement | Une règle sur le temps de réponse |
| L’authentification a silencieusement cessé d’être appliquée | 200, renvoyant des données qu’il ne devrait pas renvoyer | Un moniteur négatif dédié - une requête non authentifiée qui doit renvoyer 401 |
Cette dernière ligne mérite d’être mise en place délibérément. Un second moniteur qui n’envoie aucun identifiant et vérifie un 401 est le moyen le moins coûteux de découvrir qu’une couche d’autorisation a été accidentellement désactivée - une panne qu’aucune quantité de tests positifs ne fera jamais apparaître.
Les moniteurs d’API s’exécutent depuis le parc public de points de contrôle de HostTracker - plus de 300 points de contrôle répartis dans 158 villes - et vous choisissez les emplacements utilisés par un moniteur donné. La géographie compte davantage pour une API que pour un site web : un endpoint desservi par un CDN ou un équilibreur de charge géo-routé peut être sain à Francfort et en échec à São Paulo, et une vérification depuis un seul emplacement n’a aucun moyen de le voir. Il en va de même pour le DNS - un enregistrement périmé ou mal configuré se propage souvent de façon inégale, ce qui ressemble à une panne intermittente de l’intérieur et à une panne régionale de l’extérieur.
S’exécuter depuis de nombreux endroits soulève un risque évident : plus de points de contrôle, plus d’occasions pour un chemin réseau instable de crier au loup. HostTracker gère cela avec un quorum de confirmation. Lorsqu’un point de contrôle signale un échec, la vérification est répétée depuis d’autres points de contrôle indépendants, et le changement d’état n’est confirmé que lorsqu’ils sont d’accord - par défaut, un verdict majoritaire parmi jusqu’à sept agents, avec un minimum de trois. Vous pouvez rendre cela plus strict, en exigeant qu’un nombre défini d’agents signale l’échec ou un accord complet entre eux, pour un endpoint où une fausse alerte est pire qu’une alerte lente.
Une fois confirmée, l’alerte suit le délai choisi par chaque contact - immédiatement, ou après 3, 5, 15, 30 ou 60 minutes, ou 3, 6, 12 ou 24 heures d’échec continu - sur les neuf canaux de notification : e-mail, SMS, appel vocal, webhook, Slack, notification push et les messageries Telegram, Discord et Viber. Le canal webhook est ce qui permet aux alertes d’atteindre un outil de gestion d’incidents ou de discussion d’équipe.
La vérification est une requête HTTP configurable associée à une analyse de la réponse, ce à quoi elle s’adapte en découle directement.
data - et il vaut la peine de vérifier que le membre errors est
absent, puisque GraphQL est connu pour répondre 200 avec des erreurs à l’intérieur.Ce qui ne convient pas, c’est une séquence - obtenir un jeton, l’utiliser, puis supprimer la ressource. Un moniteur d’API effectue une seule requête par exécution. Pour un véritable parcours en plusieurs étapes, la vérification transactionnelle pilotée par navigateur est l’outil adapté ; pour le temps de chargement d’une page plutôt que d’un endpoint, voir le suivi du temps d’accès navigateur et de chargement des pages.
Ces deux approches se complètent et sont fréquemment confondues. Une plateforme d’observabilité ou d’APM instrumente votre code et vous indique ce qui s’est passé à l’intérieur d’une requête. La surveillance d’API externe se tient en dehors de votre infrastructure et vous indique ce que reçoit réellement un consommateur. Les deux méritent d’être mises en place ; aucune ne remplace l’autre.
| Surveillance d’API externe | APM / observabilité | |
|---|---|---|
| Point de vue | En dehors de votre infrastructure, via l’Internet public | À l’intérieur du processus de votre application |
| Nécessite des changements de code | Non - rien n’est installé nulle part | Un agent ou un SDK dans chaque service |
| Voit les problèmes de DNS, de routage, de TLS et de CDN | Oui - ils se trouvent sur le chemin qu’elle emprunte | Non - ils surviennent avant l’arrivée de la requête |
| Continue de rapporter même quand toute la plateforme est en panne | Oui - elle n’est pas hébergée par vous | Souvent pas - ce qui rapporte est aussi en panne |
| Explique pourquoi une requête a été lente à l’intérieur de votre code | Non - elle voit la décomposition du temps, pas votre pile applicative | Oui - c’est tout son objet |
| Couvre un endpoint que personne n’a appelé aujourd’hui | Oui - elle l’appelle selon un calendrier | Non - pas de trafic, pas de télémétrie |
Le schéma sur lequel se stabilisent la plupart des équipes est la surveillance externe pour la détection et la télémétrie interne pour le diagnostic : HostTracker vous indique qu’un endpoint est cassé, depuis où, et contre quelle règle, et votre propre traçage vous indique pourquoi. À côté de cela, un moniteur de requêtes de base de données explique souvent une API devenue lente, et la surveillance de la charge serveur explique l’hôte sur lequel elle tourne.
Un outil de surveillance d’API envoie des requêtes vers vos endpoints selon une fréquence programmée et évalue la réponse par rapport à des règles que vous définissez, plutôt que de simplement confirmer que le serveur a répondu. La surveillance d’API de HostTracker vérifie d’abord que l’endpoint est joignable et renvoie le code de statut HTTP attendu, puis contrôle que le type de contenu de la réponse correspond à ce qui est attendu (JSON, XML, texte brut, etc.), et enfin recherche dans le corps de la réponse des valeurs ou motifs spécifiques que vous avez configurés. Cette approche par couches détecte des problèmes qu’un simple contrôle « est-ce en ligne » manquerait totalement - un endpoint peut renvoyer un code 200 normal tout en retournant des données corrompues, incomplètes ou obsolètes à cause d’un bug backend, d’une requête base de données échouée, ou d’une intégration cassée plus loin dans la chaîne. Définir des règles de validation claires en amont permet au moniteur de savoir à quoi ressemble réellement une réponse saine pour votre API.
La surveillance de disponibilité d’un site web vérifie généralement qu’une page se charge et renvoie un code de statut HTTP normal, ce qui fonctionne bien pour des pages destinées à être consultées dans un navigateur. La surveillance d’API va plus loin car les API sont consommées par du code, pas par des personnes, donc une réponse « fonctionnelle » doit répondre à des exigences plus strictes : le bon type de contenu, une structure valide et des valeurs correctes dans le payload, pas seulement un code de statut réussi. Un endpoint peut renvoyer un HTTP 200 alors que les données réelles sont erronées, manquantes ou mal formées, et les contrôles de disponibilité traditionnels ne le détecteront pas puisqu’ils ne regardent que le code de réponse. La surveillance d’API de HostTracker contrôle les deux couches - joignabilité et code de statut, comme le fait la surveillance de disponibilité, plus la validation du type de contenu et la recherche de valeurs attendues dans le corps de la réponse - offrant une image bien plus précise du bon fonctionnement réel d’une API.
Oui, c’est exactement ce qui distingue la surveillance d’API d’un simple contrôle de disponibilité. HostTracker vous permet de définir des règles de validation qui vont au-delà de la simple confirmation que l’endpoint a répondu : vous pouvez spécifier le type de contenu attendu afin qu’une vérification échoue si un endpoint se met soudainement à renvoyer du HTML au lieu de JSON (symptôme fréquent d’une page d’erreur servie à la place des données réelles), et vous pouvez rechercher dans le contenu de la réponse des valeurs spécifiques qui doivent être présentes pour que la réponse soit considérée comme saine. Cela signifie qu’une vérification peut échouer même quand le code de statut HTTP paraît parfaitement normal, détectant les cas où un bug backend ou une intégration en aval défaillante produit une réponse techniquement réussie mais fonctionnellement erronée. Valider le contenu réel, pas seulement la connectivité, est ce qui rend la surveillance d’API pertinente pour les endpoints dont dépendent d’autres systèmes.
Après avoir confirmé qu’un endpoint répond et que son type de contenu correspond à vos attentes, la surveillance d’API de HostTracker recherche dans le contenu renvoyé les valeurs ou motifs de texte spécifiques que vous avez configurés dans la règle de validation de la vérification. Cela permet de confirmer qu’une réponse contient un champ, une valeur de statut ou une donnée particulière indiquant que l’endpoint fonctionne correctement - par exemple, vérifier que la réponse d’un endpoint de health-check contient bien la valeur de statut attendue plutôt qu’un message d’erreur enveloppé dans une réponse 200. Si le contenu attendu n’est pas trouvé, la vérification est marquée comme échouée même si la connexion elle-même a réussi, et vous êtes alerté via vos canaux de notification configurés. Ce type de contrôle sensible au contenu est particulièrement utile pour détecter les pannes partielles, où une API est techniquement joignable mais renvoie discrètement des données incomplètes ou incorrectes.
La fréquence de vérification est configurable, et les offres payantes de HostTracker prennent en charge des intervalles allant jusqu’à une fois par minute sur l’ensemble de ses types de surveillance, de sorte que les endpoints d’API critiques pour la disponibilité de votre application peuvent être vérifiés en quasi-continu. Le plan gratuit permanent exécute des vérifications toutes les 30 minutes sur jusqu’à deux moniteurs, ce qui est une fréquence raisonnable pour des API internes ou moins prioritaires où un léger délai de détection n’est pas coûteux. Pour les API critiques pour l’activité - celles qui alimentent une application en production, un parcours de paiement ou une intégration dont dépendent vos clients - des intervalles plus courts permettent de détecter et traiter les problèmes avant qu’ils ne se transforment en panne majeure visible par les utilisateurs. Un essai complet de 30 jours avec vérifications à la minute et sans carte bancaire vous permet de tester la vitesse de détection dont votre API a besoin.
Oui. Un moniteur d’API peut envoyer tout ce que l’endpoint exige pour accepter la requête : des en-têtes personnalisés arbitraires - c’est ainsi qu’un jeton bearer, un en-tête de clé d’API ou un identifiant de tenant est fourni - ainsi qu’un nom d’utilisateur et un mot de passe pour l’authentification HTTP, un corps de requête pour POST, PUT ou PATCH, et n’importe quelle méthode HTTP, de GET et HEAD jusqu’à POST, PUT, PATCH et DELETE. Le conseil pratique est le même que pour tout client automatisé : attribuez au moniteur son propre identifiant plutôt que de réutiliser celui d’une personne, donnez-lui la portée la plus restreinte qui exerce quand même l’endpoint de façon significative, et préférez un endpoint en lecture seule ou une route de santé dédiée à tout ce qui modifie des données. Si vos jetons sont de courte durée, pointez le moniteur vers un endpoint dont l’authentification n’expire pas - une route de santé ou de statut protégée par une clé de longue durée - plutôt que d’essayer de faire réaliser au moniteur un échange de jetons qu’il n’a aucun moyen d’effectuer.
Les vérifications d’API s’exécutent selon un intervalle allant d’une minute à 24 heures - 1, 2, 3, 5, 10, 15, 30 et 45 minutes, puis 1, 2, 4, 6, 12 et 24 heures - et un nouveau moniteur utilise trois minutes par défaut. Elles s’exécutent depuis le parc public de points de contrôle de HostTracker, qui compte plus de 300 points de contrôle répartis dans 158 villes, et vous choisissez les emplacements utilisés par un moniteur donné. S’exécuter depuis plusieurs régions compte davantage pour une API que pour un site web : un endpoint desservi par un CDN ou un équilibreur de charge géo-routé peut être parfaitement sain dans une région et en échec dans une autre, et une vérification depuis un seul emplacement ne peut tout simplement pas le voir. Cela alimente aussi le contrôle des fausses alertes - lorsqu’un point de contrôle signale un échec, la vérification est répétée depuis d’autres points de contrôle indépendants, et le changement d’état n’est confirmé qu’une fois le quorum d’accord, si bien qu’un chemin réseau instable entre un centre de données et votre hôte ne déclenche d’alerte pour personne.
Les deux. Pour un test ponctuel, la vérification HTTP gratuite exécute votre endpoint dès maintenant depuis 300+ emplacements, sans compte. Un monitoring d’API est la même requête répétée selon un planning, jusqu’à chaque minute, avec vos règles de validation appliquées à chaque réponse et une alerte dès qu’une échoue. La plupart des équipes commencent par le vérificateur pour voir ce que rapporte un emplacement, puis ajoutent le monitoring pour les endpoints dont dépendent leurs clients ou leurs intégrations.
Lorsqu’une vérification de surveillance d’API échoue - que ce soit parce que l’endpoint n’a pas répondu, a renvoyé un type de contenu inattendu, ou ne contenait pas les valeurs requises par votre règle de validation - HostTracker envoie une alerte via l’un des 9 canaux de notification que vous avez configurés, dont l’e-mail, le SMS, l’appel vocal, les webhooks, Slack, et des applications de messagerie comme Telegram, Discord et Viber. Votre équipe est ainsi informée d’une API cassée ou dégradée dès sa détection, plutôt que via un ticket de support après que l’intégration a déjà échoué silencieusement pendant des heures. Comme la vérification évalue à la fois la joignabilité et le contenu, l’alerte reflète un véritable problème fonctionnel de l’API plutôt qu’un simple incident de connectivité, ce qui aide à éviter aussi bien les incidents manqués que le bruit inutile.
Démarrez un essai gratuit et soyez alerté dès qu’un endpoint renvoie un statut incorrect, rompt son contrat, ou ralentit.
Fait partie du logiciel de monitoring site web de HostTracker.