
REST und GraphQL
Jede Methode, benutzerdefinierte Header, ein Body und Authentifizierung - und Regeln über das zurückkommende JSON.
API-Monitoring
Das API-Monitoring-Tool von HostTracker prüft Uptime, Antwortzeit und Payload Ihrer Endpunkte aus 300+ Standorten - anhand von Regeln, die Sie in einfachen Worten festlegen: ein Statuscode, ein JSON-Feld, eine Antwortzeit - und alarmiert Sie, sobald ein Aufruf nicht mehr passt.
So läuft eine API-Prüfung ab
Regeln lesen die Antwort und vergleichen sie. Zusammen decken diese vier die Schichten ab, auf die es ankommt.
api.example.com/v1/orders · 4 Regeln · bestanden
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Strukturierte Abfragen in JSON, XML, HTML oder YAML; die Weiterleitungskette Schritt für Schritt; das ausgehandelte TLS-Protokoll und die Chiffre.
Vergleichen Sie diesen Durchlauf mit dem vorherigen: ein Zähler, der nie rückwärts läuft, ein Body-Hash, der sich nicht ändern darf.
JSONPath, XPath oder ein regulärer Ausdruck wählt einen Wert aus; gleich, Bereich, Listenzugehörigkeit oder null entscheidet.
Mehr erfahrenDie Anfrage so geformt, wie der Endpunkt es erwartet, die Regeln über das, was zurückkommt.
Jede Methode, benutzerdefinierte Header, ein Body und Authentifizierung - und Regeln über das zurückkommende JSON.
Analysieren Sie den Body als XML und wählen Sie mit XPath aus. Der Umschlag ist nur eine weitere Antwort.
Senden Sie eine Nutzlast nach Zeitplan und prüfen Sie die Bestätigung, sodass ein stummer Empfänger erkannt wird, bevor es ein Partner bemerkt.
HostTracker prüft Ihre API-Endpunkte nach Zeitplan und validiert Statuscode, Content-Type und die Werte in der Antwort - nicht nur, ob der Server überhaupt antwortet.
Das Monitoring Ihrer APIs ist wirklich wichtig. Es hilft Ihnen, Leistung und Verfügbarkeit im Blick zu behalten und zu prüfen, ob sie das tun, was sie sollen. Außerdem stellt es sicher, dass die Leistungsstandards eingehalten werden, was Ihnen hilft, mögliche Probleme zu vermeiden
Uptime-Monitoring bedeutet im Grunde, einen API-Endpunkt in regelmäßigen Abständen zu prüfen, um sicherzustellen, dass er verfügbar ist, wenn Sie ihn brauchen, und einwandfrei funktioniert. Performance-Monitoring misst, wie schnell und zuverlässig eine API auf Anfragen reagiert.
Wie gut APIs funktionieren, hat großen Einfluss darauf, wie Nutzer Ihre Anwendungen erleben, wie gut sie insgesamt funktionieren, und wirkt sich sogar auf das Geschäftsergebnis aus.
Der von einer Regel extrahierte Wert wird pro Prüfung gespeichert und neben Antwortzeit und Geschwindigkeit dargestellt.
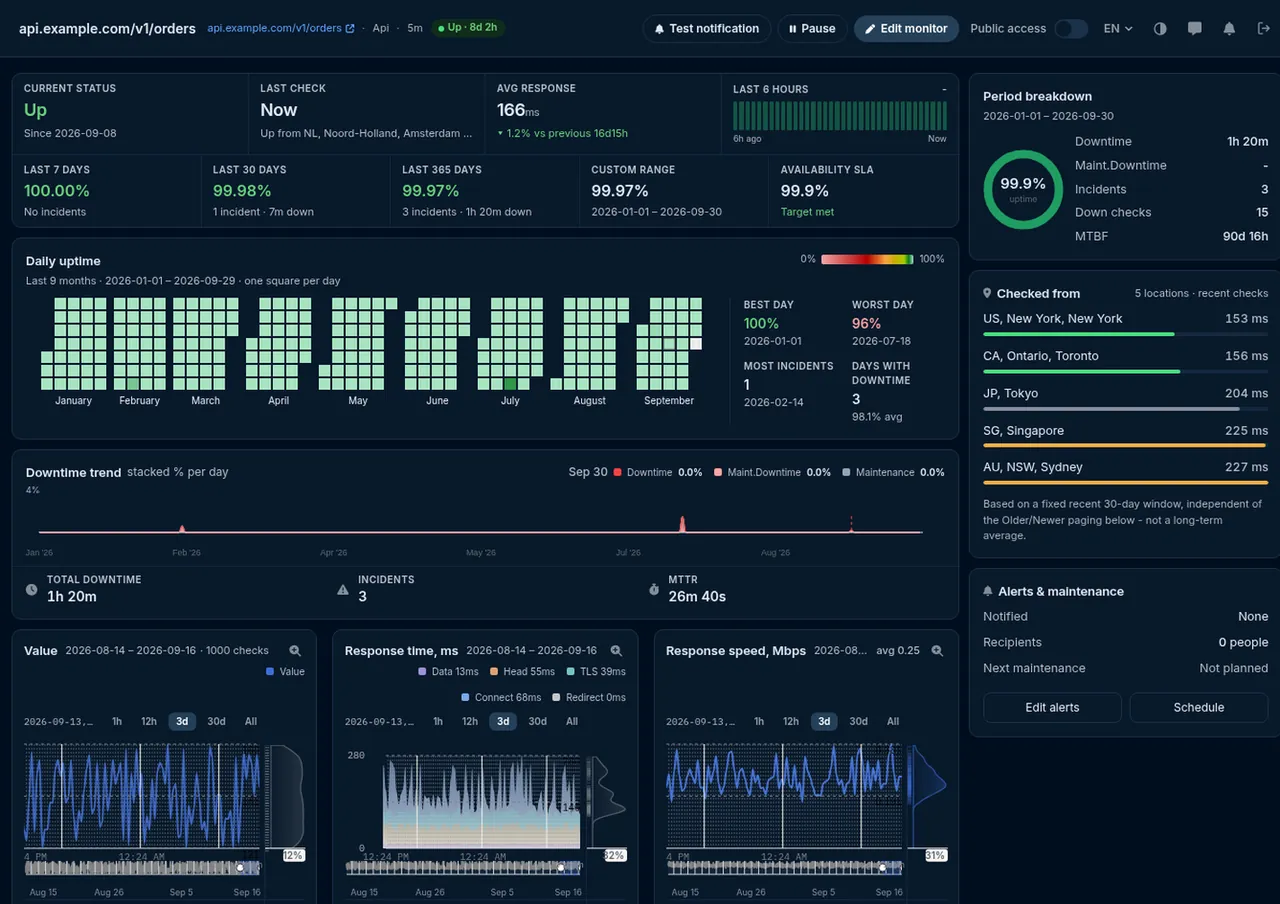
body.json.path("$.count") wird zu einer Reihe. Ein Abfall auf null ist sichtbar, bevor er zum Alarm wird.
Verbindung, TLS, Header- und Datenzeit pro Prüfung, von jedem von Ihnen gewählten Standort.
Websites, Server, APIs, Zertifikate. Ein Prüftyp pro Seite, dahinter dieselben Standorte, Alarme und Berichte.
"Ich arbeite schon lange mit diesem Überwachungsdienst und mein Alltag ist kein Problem mehr. Er beobachtet still all meine Websites und lässt mich reagieren, sobald etwas schiefgeht."
Vertraut von Teams bei
Jedes Kapitel öffnet sich an Ort und Stelle, sodass die Seite kurz bleibt.
REST-API-Monitoring sieht oberflächlich wie Uptime-Monitoring aus, ist aber eine andere Aufgabe. Eine API wird von Code konsumiert, nicht von Menschen, und Code verzeiht auf eine Art nicht, wie es ein Browser tut. Ein menschlicher Besucher toleriert eine Seite, die leicht falsch gerendert wird; eine Integration, die ein Feld vom falschen Typ erhält, bricht schlicht ab. API-Monitoring muss deshalb mehr Ebenen prüfen als „Hat der Server geantwortet“, und HostTracker prüft sie der Reihe nach, wobei der Check bei der ersten nicht erfüllten Ebene fehlschlägt.
| Ebene | Was geprüft wird | Welcher Fehler damit erkannt wird |
|---|---|---|
| 1 · Erreichbarkeit | DNS löst auf, die TCP-Verbindung öffnet sich, der TLS-Handshake wird abgeschlossen | Der Endpunkt ist verschwunden, das Zertifikat ist abgelaufen, der Host ist von einem Teil der Welt aus nicht routbar |
| 2 · Status | Der HTTP-Statuscode, gegen die Codes, die Sie akzeptieren oder ausdrücklich als Fehler behandeln | Ein 500 nach einem Deployment, ein 401 durch abgelaufene Zugangsdaten, ein unerwarteter 429 |
| 3 · Zeitverhalten | Gesamte Antwortzeit sowie ihre Aufschlüsselung auf Connect, TLS, Header und Body | Ein Endpunkt, der noch funktioniert, aber still von 200 ms auf vier Sekunden angestiegen ist |
| 4 · Form | Content-Type und Header - ist das wirklich JSON, oder eine HTML-Fehlerseite mit einem 200 als Tarnung | Eine Fehlerseite oder eine Login-Weiterleitung, wo eigentlich ein Payload stehen sollte. Der klassische stille API-Ausfall |
| 5 · Inhalt | Ein aus dem Payload ausgewählter Wert, oder frei formulierte Assertions über die gesamte Antwort | Ein nach einer Schema-Änderung fehlendes Feld, eine leere Ergebnismenge, eine zurückgerollte Versionskennung, ein Error-Member innerhalb einer erfolgreichen Antwort |
Die Ebenen eins bis drei sind das, was ein gewöhnlicher Uptime-Check liefert. Vier und fünf sind das, was daraus API-Monitoring macht - und genau dort spielen sich die meisten echten API-Vorfälle tatsächlich ab.
Bevor irgendetwas validiert werden kann, muss der Monitor die Anfrage stellen, die Ihre API erwartet. Der vollständige Anfrageumfang steht auf einem API-Monitor zur Verfügung:
| Einstellung | Was Sie damit tun können |
|---|---|
| HTTP-Methode | GET, HEAD, POST, PUT, PATCH oder DELETE |
| Eigene Header | Beliebige Name-Wert-Paare, die Sie brauchen - ein Bearer-Token, ein API-Key, eine Mandanten-Kennung, ein Accept-Versions-Header. Header werden bei einer Weiterleitung nur zum selben Host weitergereicht, sodass ein Zugangsdatum niemals an einen Dritten durchsickert, an den Ihr Endpunkt weiterleitet. |
| Request-Body | Ein Rohtext-Body für POST, PUT und PATCH, oder formularkodierte Parameter |
| HTTP-Authentifizierung | Benutzername und Passwort, mit dem vom Server geforderten Schema, das auf der Verbindung ausgehandelt wird |
| Weiterleitungen | Folgen oder nicht, die Anzahl der gefolgten Weiterleitungen begrenzen, oder jede Weiterleitung grundsätzlich als Fehler werten - nützlich für einen Endpunkt, der direkt antworten muss |
| Timeout | Bis zu 100 Sekunden, Standard 40 - und ein Timeout gilt als fehlgeschlagener Check, genau das, was Sie sich von einem Endpunkt mit SLA wünschen |
| Obergrenze für Antwortgröße | Standardmäßig 1 MB, kann erhöht werden, damit eine ausufernde Antwort den Check nicht verschluckt |
| Akzeptierte und abgelehnte Statuscodes | Listen von zu ignorierenden Codes und von Codes, die als Fehler gelten - das Werkzeug für einen Endpunkt, der 401 oder 404 legitim als Teil seines Vertrags liefert |
| DNS-Kontrolle | Über bestimmte Resolver auflösen, den DNS-Cache des Prüfpunkts umgehen, und prüfen, auf welche IP-Adressen der Host auflöst |
| TLS-Strenge | Optional eine gültige Zertifikatskette, TLS 1.2 oder besser, Cipher über 128-Bit und eine Widerrufsprüfung verlangen - zusätzlich zur Zertifikats-Ablaufüberwachung auf derselben Verbindung |
Der ausdrucksstärkste Weg, eine Antwort zu validieren, ist, Regeln dafür zu schreiben. Jede Regel ist eine Zeile, Regeln werden mit UND verknüpft, und ein Monitor kann bis zu zwanzig davon tragen. Das ist das verifizierte Einstiegspaket für eine JSON-API:
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Vier Zeilen, und zusammen decken sie die vier Ebenen ab, auf die es ankommt: Der Endpunkt hat mit einem
2xx geantwortet, er hat mit JSON statt einer Fehlerseite geantwortet, der Payload enthält ein echtes
Ergebnis statt eines leeren, und all das geschah innerhalb des Zeitbudgets. Einzeln nützliche Regeln aus
demselben Katalog sind unter anderem body.json.path("$.status") eq "ok" für das eigene
Health-Urteil einer API, body.json.path("$.error") absent für ein Error-Member, das in
einer sonst erfolgreichen Antwort auftaucht, body.json.path("$.version") eq "2.4.1", um ein
ungewolltes Rollback zu erkennen, redirects.count eq 0 für einen Endpunkt, der direkt
antworten soll, und cert.days.left gt 14 für das Zertifikat auf derselben Verbindung.
Regeln lesen Subjekte aus der Antwort und vergleichen sie. Die Subjekte umfassen den Statuscode; die
gesamte Antwortzeit und ihre Bestandteile Connect, TLS, DNS, Header und Body; den rohen Body samt seiner
Größe und eines Hashes davon; strukturierte Abfragen in den Payload als JSON, XML, HTML oder YAML;
einzelne Antwort-Header; die finale und die ursprüngliche URL sowie deren Bestandteile; die
Weiterleitungskette Hop für Hop; die verbleibenden Tage, den Aussteller und die Namen des Zertifikats;
das ausgehandelte TLS-Protokoll und den Cipher; die von DNS zurückgegebenen Adressen; und
Set-Cookie. Vergleiche reichen vom Offensichtlichen - gleich, kleiner als, größer als -
über contains, startsWith, endsWith, matches für
einen regulären Ausdruck, containsAny und containsAll für eine Menge,
in für eine Liste akzeptabler Werte, bis zu exists, isNumber und
unique.
Es gibt außerdem eine Änderungserkennungs-Achse: Eine Regel kann den Wert dieses Laufs mit dem des vorherigen vergleichen, sodass Sie sicherstellen können, dass ein Zähler niemals zurückgeht oder sich ein Body-Hash nicht verändert hat - die Art von Regel, die ein stilles Rollback oder eine unautorisierte Inhaltsänderung erkennt statt eines Ausfalls.
Neben der Regelsprache gibt es einen einfacheren Ein-Wert-Pfad, der hier schon lange Teil des API-Monitorings ist und oft alles ist, was ein Check braucht. Sie sagen dem Monitor, wie er den Body parsen soll, wie er einen Wert daraus auswählt und was dieser Wert sein muss:
Das auf den ausgewählten Wert angewendete Prädikat umfasst gleich und ungleich, kleiner-als und größer-als jeweils in strikter und einschließender Form, Zugehörigkeit zu einer Liste akzeptabler Werte oder Ausschluss davon, innerhalb oder außerhalb eines numerischen Bereichs, sowie einen Test darauf, ob der Wert null oder vollständig fehlend ist.
Ein fehlerhafter Selektor wird beim Speichern abgelehnt, nicht um drei Uhr morgens. Der Selektor wird bei der Validierung kompiliert, sodass ein Tippfehler in einem JSONPath oder XPath ein Fehler im Formular ist - statt eines Monitors, der seit seiner Erstellung im Stillen fehlschlägt oder im Stillen besteht.
Jeder Fehler in dieser Tabelle liefert HTTP 200. Das ist das gesamte Problem, wenn man eine API nur anhand ihres Statuscodes überwacht: Der Transport war erfolgreich, also meldet der Transport Erfolg.
| Was schiefgegangen ist | Wie die Antwort aussieht | Was es erkennt |
|---|---|---|
| Eine Fehlerseite wird ausgeliefert, wo eigentlich ein Payload stehen sollte | 200, mit HTML | Eine Content-Type-Assertion, oder eine Regel, dass der Body als JSON parst |
| Der Suchindex hat aufgehört, sich neu aufzubauen | 200, mit leerem Ergebnis-Array | Eine Regel, dass die Ergebnisanzahl mindestens eins ist |
| Ein Feld wurde bei einer Schema-Änderung umbenannt | 200, gültiges JSON, fehlendes Element | Eine Regel, dass das Feld existiert |
| Ein Deployment wurde zurückgerollt, ohne dass es jemand bemerkte | 200, ältere Versionskennung | Eine Regel, die das Versionsfeld fixiert |
| Ein Error-Member erscheint innerhalb einer Erfolgs-Hülle | 200, mit gesetztem Error-Member | Eine Regel, dass das Error-Member fehlt |
| Eine nachgelagerte Abhängigkeit fällt aus, und die API degradiert kontrolliert | 200, mit teilweisen oder veralteten Daten | Eine Regel auf das eigene Health-Feld der API, oder ein Aktualitätswert im Payload |
| Der Endpunkt antwortet jetzt in vier Sekunden statt in zweihundert Millisekunden | 200, irgendwann | Eine Antwortzeit-Regel |
| Die Authentifizierung wird im Stillen nicht mehr angewendet | 200, mit Daten, die eigentlich nicht ausgeliefert werden sollten | Ein dedizierter Negativ-Monitor - eine unauthentifizierte Anfrage, die 401 liefern muss |
Diese letzte Zeile lohnt sich, bewusst umzusetzen. Ein zweiter Monitor, der keine Zugangsdaten sendet und auf einen 401 prüft, ist der günstigste Weg herauszufinden, dass eine Autorisierungsschicht versehentlich deaktiviert wurde - ein Fehler, den kein noch so umfangreiches positives Testen jemals zutage fördern würde.
API-Monitore laufen über das öffentliche Prüfstationsnetz von HostTracker - über 300 Prüfpunkte in 158 Städten -, und Sie wählen aus, welche Standorte ein bestimmter Monitor nutzt. Geografie ist bei einer API noch wichtiger als bei einer Website: Ein Endpunkt hinter einem CDN oder einem geo-basierten Load Balancer kann in Frankfurt gesund sein und in São Paulo ausfallen, und ein Check von nur einem Standort kann das gar nicht sehen. Dasselbe gilt für DNS - ein veralteter oder falsch konfigurierter Eintrag verbreitet sich oft ungleichmäßig, was von innen wie ein sporadischer Ausfall aussieht und von außen wie ein regionaler.
Die Prüfung von vielen Standorten aus birgt ein offensichtliches Risiko: mehr Prüfpunkte, mehr Gelegenheiten für einen einzelnen instabilen Netzwerkpfad, Fehlalarm zu schlagen. HostTracker begegnet dem mit einem Bestätigungs-Quorum. Meldet ein Prüfpunkt einen Fehler, wird der Check an zusätzlichen, unabhängigen Prüfpunkten wiederholt, und der Statuswechsel wird erst bestätigt, wenn sie sich einig sind - standardmäßig ein Mehrheitsvotum über bis zu sieben Agenten, mit einem Minimum von drei. Sie können das strenger einstellen und eine feste Anzahl von Agenten verlangen, die den Fehler melden müssen, oder volle Übereinstimmung unter ihnen, für einen Endpunkt, bei dem eine falsche Benachrichtigung schlimmer ist als eine langsame.
Nach der Bestätigung folgt die Benachrichtigung der von jedem Kontakt gewählten Verzögerung - sofort, oder nach 3, 5, 15, 30 oder 60 Minuten, oder nach 3, 6, 12 oder 24 Stunden ununterbrochenen Fehlers - über die neun Benachrichtigungskanäle: E-Mail, SMS, Anruf, Webhook, Slack, Web-Push und die Messenger-Apps Telegram, Discord und Viber. Der Webhook-Kanal ist der Weg, auf dem Benachrichtigungen einen Incident-Manager oder ein Team-Chat-Tool erreichen.
Der Check ist eine konfigurierbare HTTP-Anfrage plus Antwortanalyse, und daraus ergibt sich direkt, wofür er sich eignet.
data hinein - und es lohnt sich, zu prüfen, dass das errors-Element fehlt,
denn GraphQL antwortet bekanntlich mit 200, obwohl Fehler enthalten sind.Was nicht passt, ist eine Abfolge - ein Token holen, es verwenden, dann die Ressource löschen. Ein API-Monitor stellt eine Anfrage pro Lauf. Für einen echten mehrstufigen Ablauf ist der browsergesteuerte Transaktionscheck das richtige Werkzeug; für die Zeitmessung einer Seite statt eines Endpunkts siehe Browser-Zugriff und Seitenladezeit.
Beide ergänzen sich und werden häufig verwechselt. Eine Observability- oder APM-Plattform instrumentiert Ihren Code und sagt Ihnen, was innerhalb einer Anfrage passiert ist. Externes API-Monitoring steht außerhalb Ihrer Infrastruktur und sagt Ihnen, was ein Konsument tatsächlich erhält. Beides lohnt sich; keines ersetzt das andere.
| Externes API-Monitoring | APM / Observability | |
|---|---|---|
| Blickwinkel | Außerhalb Ihrer Infrastruktur, über das öffentliche Internet | Innerhalb Ihres Anwendungsprozesses |
| Erfordert Code-Änderungen | Nein - nirgendwo wird etwas installiert | Ein Agent oder SDK in jedem Dienst |
| Erkennt DNS-, Routing-, TLS- und CDN-Probleme | Ja - sie liegen auf dem Weg, den er nimmt | Nein - sie passieren, bevor die Anfrage ankommt |
| Meldet sich auch, wenn die gesamte Plattform down ist | Ja - es wird nicht bei Ihnen gehostet | Oft nicht - das Meldesystem selbst ist ebenfalls down |
| Erklärt, warum eine Anfrage in Ihrem Code langsam war | Nein - es sieht die Zeitaufschlüsselung, nicht Ihren Stack | Ja - genau dafür ist es da |
| Deckt einen Endpunkt ab, den heute niemand aufgerufen hat | Ja - es ruft ihn nach Zeitplan auf | Nein - kein Traffic, keine Telemetrie |
Das Muster, bei dem die meisten Teams landen, ist externes Monitoring für die Erkennung und interne Telemetrie für die Diagnose: HostTracker sagt Ihnen, dass ein Endpunkt kaputt ist, von wo aus, und gegen welche Regel, und Ihr eigenes Tracing sagt Ihnen, warum. Ergänzend dazu erklärt oft ein Datenbank-Query-Monitor, warum eine API langsam geworden ist, und Server-Lastüberwachung erklärt den Host, auf dem sie läuft.
Ein API-Monitoring-Tool sendet nach einem festen Zeitplan Anfragen an Ihre API-Endpunkte und bewertet die Antwort anhand von Regeln, die Sie selbst festlegen - statt nur zu bestätigen, dass der Server überhaupt geantwortet hat. Das API-Monitoring von HostTracker prüft zunächst, ob der Endpunkt erreichbar ist und den erwarteten HTTP-Statuscode zurückgibt, kontrolliert dann, ob der Content-Type der Antwort dem erwarteten Format entspricht (JSON, XML, Klartext usw.), und durchsucht schließlich den Antworttext nach bestimmten Werten oder Mustern, die Sie konfiguriert haben. Dieser mehrstufige Ansatz erkennt Probleme, die eine einfache „Ist es erreichbar?“-Prüfung völlig übersehen würde - ein Endpunkt kann einen normalen 200er-Statuscode liefern und trotzdem beschädigte, unvollständige oder veraltete Daten zurückgeben, etwa wegen eines Backend-Fehlers, einer fehlgeschlagenen Datenbankabfrage oder einer defekten Integration weiter hinten in der Kette. Klar definierte Validierungsregeln sorgen dafür, dass das Monitoring genau weiß, wie eine gesunde Antwort für Ihre spezifische API aussehen muss.
Website-Uptime-Monitoring prüft in der Regel nur, ob eine Seite lädt und einen normalen HTTP-Statuscode zurückgibt - das funktioniert gut für Seiten, die im Browser angezeigt werden sollen. API-Monitoring geht weiter, denn APIs werden von Code und nicht von Menschen genutzt, sodass eine „funktionierende“ Antwort strengere Anforderungen erfüllen muss: den richtigen Content-Type, eine gültige Struktur und korrekte Werte im Payload - nicht nur einen erfolgreichen Statuscode. Ein Endpunkt kann HTTP 200 zurückgeben, obwohl die eigentlichen Daten falsch, unvollständig oder fehlerhaft formatiert sind, und klassische Uptime-Checks erkennen das allein nicht, da sie nur den Statuscode betrachten. Das API-Monitoring von HostTracker prüft beide Ebenen - Erreichbarkeit und Statuscode wie beim Uptime-Monitoring, plus Content-Type-Validierung und die Suche nach erwarteten Werten im Antworttext - und liefert damit ein deutlich genaueres Bild davon, ob eine API wirklich einwandfrei funktioniert.
Ja, genau das macht den Kern von API-Monitoring gegenüber einer einfachen Uptime-Prüfung aus. Mit HostTracker legen Sie Validierungsregeln fest, die über die reine Bestätigung der Erreichbarkeit hinausgehen: Sie können den erwarteten Content-Type angeben, sodass ein Check fehlschlägt, wenn ein Endpunkt unerwartet HTML statt JSON zurückliefert (ein typisches Symptom dafür, dass eine Fehlerseite statt echter Daten ausgeliefert wird), und Sie können den Antwortinhalt nach bestimmten Werten durchsuchen lassen, die vorhanden sein müssen, damit die Antwort als gesund gilt. Dadurch kann ein Check fehlschlagen, obwohl der HTTP-Statuscode völlig normal aussieht - so werden Fälle erkannt, in denen ein Backend-Fehler oder eine defekte nachgelagerte Integration eine technisch erfolgreiche, aber funktional falsche Antwort erzeugt. Erst die Validierung der tatsächlichen Inhalte - nicht nur der Konnektivität - macht API-Monitoring für Endpunkte sinnvoll, von denen andere Systeme abhängen.
Nachdem bestätigt wurde, dass ein Endpunkt antwortet und der Content-Type Ihren Erwartungen entspricht, durchsucht das API-Monitoring von HostTracker den zurückgegebenen Inhalt nach den konkreten Werten oder Textmustern, die Sie als Teil der Validierungsregeln des Checks konfiguriert haben. So können Sie sicherstellen, dass eine Antwort ein bestimmtes Feld, einen Statuswert oder eine Dateneinheit enthält, die anzeigt, dass der Endpunkt korrekt funktioniert - etwa, dass die Antwort eines Health-Check-Endpunkts den erwarteten Statuswert enthält und nicht eine Fehlermeldung, die in eine 200er-Antwort verpackt wurde. Wird der erwartete Inhalt nicht gefunden, gilt der Check als fehlgeschlagen, obwohl die Verbindung selbst erfolgreich war, und Sie werden über Ihre konfigurierten Benachrichtigungskanäle alarmiert. Diese inhaltsbewusste Prüfung eignet sich besonders gut, um Teilausfälle zu erkennen, bei denen eine API zwar technisch erreichbar ist, aber im Stillen unvollständige oder fehlerhafte Daten liefert.
Die Prüffrequenz ist konfigurierbar, und die kostenpflichtigen Pläne von HostTracker unterstützen für alle Monitoring-Arten Intervalle von bis zu einer Minute, sodass kritische API-Endpunkte nahezu durchgehend geprüft werden können. Der dauerhaft kostenlose Plan führt Checks alle 30 Minuten auf bis zu zwei Monitoren aus - eine angemessene Frequenz für weniger kritische oder interne APIs, bei denen eine kurze Verzögerung bei der Problemerkennung nicht ins Gewicht fällt. Bei geschäftskritischen APIs - solchen, die eine Live-Anwendung, einen Zahlungsprozess oder eine Integration antreiben, auf die Ihre Kunden angewiesen sind - sorgen kürzere Intervalle dafür, dass Probleme erkannt und behoben werden, bevor sie zu einem größeren, für Nutzer spürbaren Ausfall eskalieren. Eine 30-tägige Testphase mit vollem Funktionsumfang, 1-Minuten-Checks und ohne Kreditkarte zeigt Ihnen, wie schnell die Erkennung für Ihre spezifische API sein muss.
Ja. Ein API-Monitor kann alles senden, was der Endpunkt braucht, um die Anfrage zu akzeptieren: beliebige eigene Header - so werden ein Bearer-Token, ein API-Key-Header oder eine Mandanten-Kennung übergeben -, dazu Benutzername und Passwort für HTTP-Authentifizierung, einen Request-Body für POST, PUT oder PATCH sowie jede HTTP-Methode von GET und HEAD bis POST, PUT, PATCH und DELETE. Der praktische Rat ist derselbe wie für jeden automatisierten Client: Stellen Sie dem Monitor eigene Zugangsdaten aus, statt die einer Person wiederzuverwenden, geben Sie ihm den engstmöglichen Geltungsbereich, der den Endpunkt noch sinnvoll auslöst, und bevorzugen Sie einen schreibgeschützten Endpunkt oder eine eigene Health-Route gegenüber allem, was Daten verändert. Sind Ihre Tokens kurzlebig, richten Sie den Monitor auf einen Endpunkt, dessen Authentifizierung nicht abläuft - eine Health- oder Status-Route, geschützt durch einen langlebigen Schlüssel -, statt zu versuchen, den Monitor einen Token-Austausch durchführen zu lassen, den er gar nicht leisten kann.
API-Checks laufen in einem Intervall von einer Minute bis zu 24 Stunden - 1, 2, 3, 5, 10, 15, 30 und 45 Minuten, dann 1, 2, 4, 6, 12 und 24 Stunden -, und ein neuer Monitor ist standardmäßig auf drei Minuten eingestellt. Sie laufen über das öffentliche Prüfstationsnetz von HostTracker, das über 300 Prüfpunkte in 158 Städten umfasst, und Sie wählen aus, welche Standorte ein bestimmter Monitor nutzt. Die Prüfung aus mehreren Regionen ist bei einer API noch wichtiger als bei einer Website: Ein Endpunkt hinter einem CDN oder einem geo-basierten Load Balancer kann in einer Region völlig gesund sein und in einer anderen ausfallen, und ein Check von nur einem Standort kann das schlicht nicht sehen. Das treibt auch die Fehlalarm-Kontrolle an - meldet ein Prüfpunkt einen Fehler, wird der Check von anderen unabhängigen Prüfpunkten wiederholt, und der Statuswechsel wird erst bestätigt, wenn das Quorum zustimmt, sodass ein einzelner instabiler Netzwerkpfad zwischen einem Rechenzentrum und Ihrem Host niemanden alarmiert.
Beides. Für einen einmaligen Test führt der kostenlose HTTP-Check Ihren Endpunkt sofort aus 300+ Standorten aus - ohne Konto. Ein API-Monitor ist dieselbe Anfrage, wiederholt nach einem Zeitplan, bis zu jede Minute, mit Ihren Validierungsregeln auf jede Antwort angewendet und einem Alarm, sobald eine fehlschlägt. Die meisten Teams starten mit dem Checker, um zu sehen, was ein Standort meldet, und fügen dann den Monitor für die Endpunkte hinzu, von denen ihre Kunden oder Integrationen abhängen.
Schlägt ein API-Monitoring-Check fehl - sei es, weil der Endpunkt nicht geantwortet hat, einen unerwarteten Content-Type zurückgegeben hat oder die von Ihrer Validierungsregel geforderten Werte fehlen -, sendet HostTracker eine Benachrichtigung über die von Ihnen konfigurierten der 9 Benachrichtigungskanäle, darunter E-Mail, SMS, Sprachanruf, Webhooks, Slack und die Messenger-Apps Telegram, Discord und Viber. So erfährt Ihr Team im Moment der Erkennung von einer defekten oder beeinträchtigten API, statt erst Stunden später durch ein Support-Ticket, nachdem die Integration bereits im Stillen fehlgeschlagen ist. Da der Check sowohl Erreichbarkeit als auch Inhalt bewertet, spiegelt der Alarm ein reales funktionales Problem der API wider und nicht nur eine kurze Verbindungsstörung - das hilft, sowohl übersehene Vorfälle als auch unnötigen Alarmlärm zu vermeiden.
Starten Sie eine kostenlose Testphase und werden Sie sofort alarmiert, wenn ein Endpunkt den falschen Status zurückgibt, seinen Vertrag bricht oder langsamer wird.
Teil der Website-Monitoring-Software von HostTracker.