
REST e GraphQL
Qualsiasi metodo, intestazioni personalizzate, un corpo e l'autenticazione - e regole sul JSON che torna indietro.
Monitoraggio API
Lo strumento di monitoraggio API di HostTracker controlla uptime, tempo di risposta e payload dei tuoi endpoint da oltre 300 località, in base a regole che scrivi in termini semplici - un codice di stato, un campo JSON, un tempo di risposta - e ti avvisa nel momento in cui una chiamata smette di corrispondervi.
Come funziona un controllo API
Le regole leggono la risposta e confrontano. Insieme, queste quattro righe coprono gli strati che contano.
api.example.com/v1/orders · 4 regole · superato
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Query strutturate in JSON, XML, HTML o YAML; la catena di reindirizzamenti passo dopo passo; il protocollo TLS negoziato e il cifrario.
Confronta questa esecuzione con la precedente: un contatore che non torna mai indietro, un hash del corpo che non deve cambiare.
JSONPath, XPath o un'espressione regolare estrae un valore; uguale, intervallo, appartenenza a un elenco o null decide.
Scopri di piùLa richiesta modellata come l'endpoint si aspetta, le regole su ciò che torna indietro.
Qualsiasi metodo, intestazioni personalizzate, un corpo e l'autenticazione - e regole sul JSON che torna indietro.
Analizza il corpo come XML e seleziona con XPath. La busta è solo un'altra risposta.
Invia un payload secondo una pianificazione e verifica la conferma di ricezione, così un ricevitore silenzioso viene individuato prima che un partner se ne accorga.
HostTracker controlla i tuoi endpoint API secondo una pianificazione, validando il codice di stato, il content type e i valori all'interno della risposta - non solo se il server risponde.
Monitorare le tue API è davvero importante. Ti aiuta a tenere sotto controllo le loro prestazioni, la loro disponibilità e se fanno effettivamente ciò per cui sono state create. Assicura inoltre che rispettino gli standard di prestazione, aiutandoti a evitare potenziali problemi
Il monitoraggio dell'uptime consiste essenzialmente nel controllare un endpoint API a intervalli regolari per assicurarsi che sia disponibile quando serve e che funzioni bene. Il monitoraggio delle prestazioni misura invece quanto rapidamente e in modo affidabile un'API risponde alle richieste.
Il buon funzionamento delle API può avere un forte impatto sull'esperienza degli utenti con le app, sul loro funzionamento complessivo e persino sui risultati economici dell'azienda.
Il valore estratto da una regola viene memorizzato a ogni controllo e tracciato accanto al tempo di risposta e alla velocità.
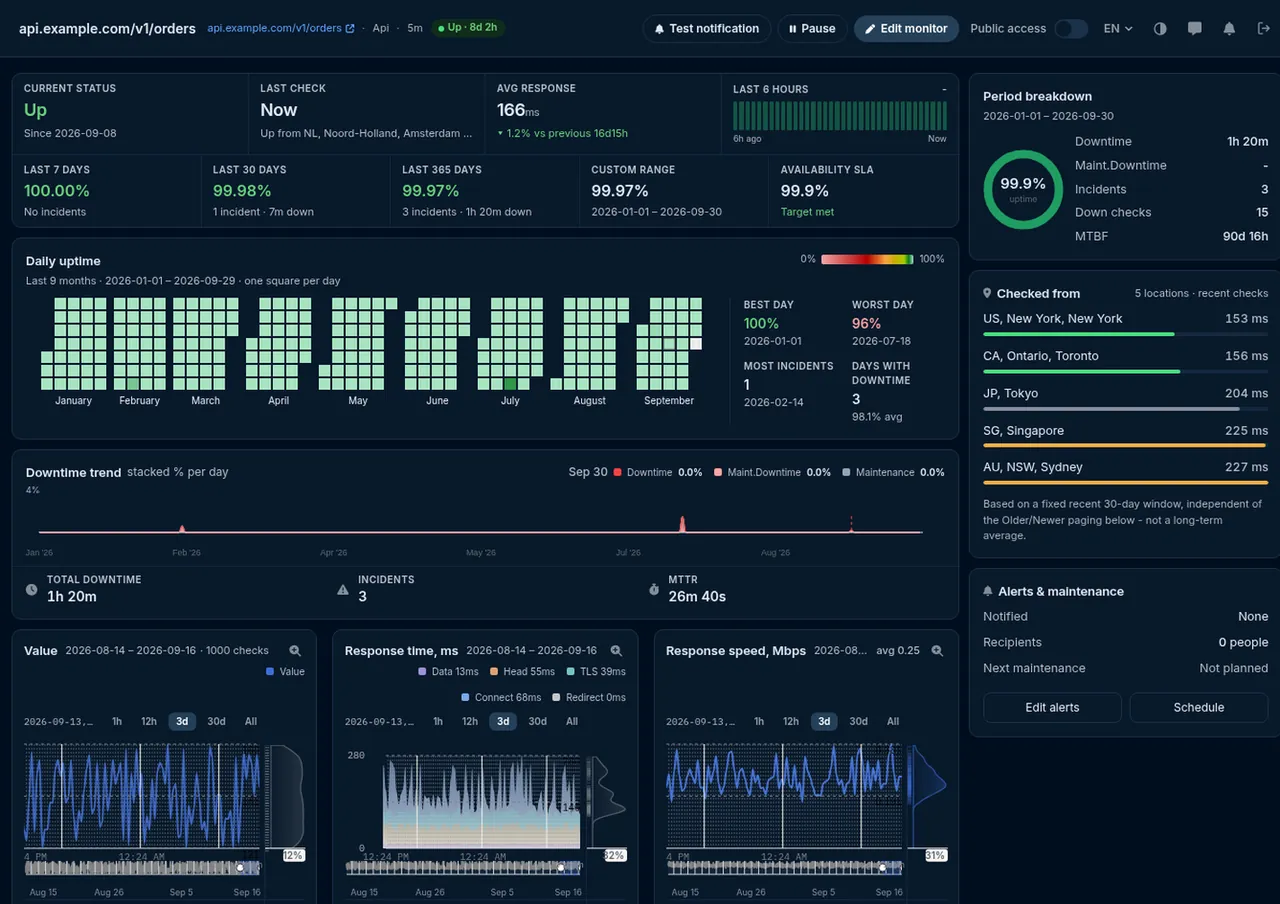
body.json.path("$.count") diventa una serie. Un calo a zero è visibile prima di diventare un'allerta.
Tempo di connessione, TLS, intestazione e dati per controllo, da ogni sede che hai scelto.
Siti web, server, API, certificati. Un tipo di controllo per pagina, con le stesse località, avvisi e report alle spalle.
"Lavoro con questo servizio di monitoraggio da molto tempo e la mia routine quotidiana non è più un problema. Controlla silenziosamente tutti i miei siti e mi permette di reagire nel momento in cui qualcosa va storto."
Scelto da team come
Ogni capitolo si apre sul posto, così la pagina resta breve.
Il monitoraggio delle API REST assomiglia superficialmente al monitoraggio uptime, ma è un lavoro diverso. Un'API viene consumata da codice, non da persone, e il codice è spietato in modi in cui un browser non lo è. Un visitatore umano tollera una pagina che si visualizza in modo leggermente sbagliato; un'integrazione che riceve un campo del tipo sbagliato semplicemente si rompe. Quindi il monitoraggio API deve controllare più livelli di un semplice "il server ha risposto", e HostTracker li controlla in ordine, facendo fallire il controllo al primo che non regge.
| Livello | Cosa viene verificato | Il guasto che intercetta |
|---|---|---|
| 1 · Raggiungibilità | Il DNS si risolve, la connessione TCP si apre, l'handshake TLS si completa | L'endpoint è scomparso, il certificato è scaduto, l'host non è instradabile da parte del mondo |
| 2 · Stato | Il codice di stato HTTP, rispetto ai codici che accetti o tratti esplicitamente come errori | Un 500 dopo un rilascio, un 401 da una credenziale scaduta, un 429 inatteso |
| 3 · Tempistica | Il tempo di risposta totale, e la sua scomposizione tra connessione, TLS, intestazioni e corpo | Un endpoint che funziona ancora ma è silenziosamente passato da 200 ms a quattro secondi |
| 4 · Forma | Content type e intestazioni - è davvero JSON, o una pagina di errore HTML travestita da 200 | Una pagina di errore o un reindirizzamento al login servito dove dovrebbe esserci un payload. Il classico guasto API silenzioso |
| 5 · Contenuto | Un valore selezionato dal payload, oppure verifiche libere sull'intera risposta | Un campo mancante dopo una modifica dello schema, un insieme di risultati vuoto, una stringa di versione tornata indietro, un membro di errore che compare dentro una risposta di successo |
I livelli da uno a tre sono ciò che ti offre un normale controllo uptime. Il quarto e il quinto sono ciò che lo rende monitoraggio API - e sono i livelli in cui vive davvero la maggior parte degli incidenti API reali.
Prima che qualcosa possa essere validato, il monitor deve effettuare la richiesta che la tua API si aspetta. L'intera superficie della richiesta è disponibile su un monitor API:
| Impostazione | Cosa puoi farci |
|---|---|
| Metodo HTTP | GET, HEAD, POST, PUT, PATCH o DELETE |
| Intestazioni personalizzate | Qualsiasi coppia nome-valore ti serva - un bearer token, una chiave API, un identificativo di tenant, un'intestazione Accept con versione. Le intestazioni vengono inoltrate solo verso lo stesso host durante un reindirizzamento, così una credenziale non finisce mai a una terza parte verso cui il tuo endpoint rimbalza. |
| Corpo della richiesta | Un corpo grezzo per POST, PUT e PATCH, oppure parametri con codifica form |
| Autenticazione HTTP | Un nome utente e una password, con lo schema richiesto dal server negoziato sulla connessione |
| Reindirizzamenti | Seguili o no, limita quanti vengono seguiti, oppure tratta qualsiasi reindirizzamento come un fallimento - utile per un endpoint che deve rispondere direttamente |
| Timeout | Fino a 100 secondi, con 40 come valore predefinito - e un timeout è un fallimento del controllo, esattamente ciò che vuoi da un endpoint con uno SLA |
| Limite dimensione risposta | Predefinito a 1 MB e può essere aumentato, così una risposta fuori controllo non può consumare il controllo |
| Codici di stato accettati e rifiutati | Elenchi di codici da ignorare, e codici da trattare come errori - lo strumento per un endpoint che risponde legittimamente 401 o 404 come parte del proprio contratto |
| Controllo DNS | Risolvi tramite resolver specifici, ignora la cache DNS della postazione, e verifica a quali indirizzi IP si risolve l'host |
| Rigore TLS | Attiva facoltativamente la richiesta di una catena di certificati valida, TLS 1.2 o superiore, cifrari sopra i 128 bit, e un controllo di revoca - più il controllo della scadenza del certificato sulla stessa connessione |
Il modo più espressivo per validare una risposta è scriverci delle regole. Ogni regola è una riga, le regole si combinano con AND, e un monitor può portarne fino a venti. Questo è il pacchetto di partenza verificato per un'API JSON:
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Quattro righe che insieme coprono i quattro livelli che contano: l'endpoint ha risposto con un 2xx, ha
risposto con JSON invece che con una pagina di errore, il payload contiene un risultato reale invece
che vuoto, e ha fatto tutto questo entro il budget. Regole singolarmente utili dello stesso catalogo
includono body.json.path("$.status") eq "ok" per il verdetto di salute proprio dell'API,
body.json.path("$.error") absent per un membro di errore che compare in una risposta
altrimenti di successo, body.json.path("$.version") eq "2.4.1" per intercettare un
rollback non voluto, redirects.count eq 0 per un endpoint che deve rispondere
direttamente, e cert.days.left gt 14 per il certificato sulla stessa connessione.
Le regole leggono soggetti dalla risposta e li confrontano. I soggetti coprono il codice di stato; il
tempo di risposta totale e le sue componenti di connessione, TLS, DNS, intestazioni e corpo; il corpo
grezzo insieme alla sua dimensione e a un suo hash; query strutturate nel payload come JSON, XML, HTML
o YAML; le singole intestazioni della risposta; l'URL finale e quello originale e le loro parti; la
catena di reindirizzamenti, passaggio per passaggio; i giorni rimanenti del certificato, l'autorità
emittente e i nomi; il protocollo TLS e il cifrario negoziati; gli indirizzi restituiti dal DNS; e
Set-Cookie. I confronti vanno dagli ovvi - uguale, minore di, maggiore di - fino a
contains, startsWith, endsWith, matches per
un'espressione regolare, containsAny e containsAll per un insieme,
in per un elenco di valori accettabili, e exists, isNumber e
unique.
Esiste anche un asse di rilevamento dei cambiamenti: una regola può confrontare il valore di questa esecuzione con quello dell'esecuzione precedente, così puoi verificare che un contatore non torni mai indietro o che un hash del corpo non sia cambiato - il tipo di regola che intercetta un rollback silenzioso o una modifica non autorizzata del contenuto, piuttosto che un'interruzione.
Accanto al linguaggio delle regole esiste un percorso più semplice, a valore singolo, che fa parte del monitoraggio API qui da molto tempo ed è spesso tutto ciò di cui un controllo ha bisogno. Indichi al monitor come analizzare il corpo, come selezionarne un valore, e cosa quel valore deve essere:
Il predicato applicato al valore selezionato copre uguale e diverso, minore e maggiore sia in forma stretta sia inclusiva, appartenenza a un elenco di valori accettabili o esclusione da esso, dentro o fuori un intervallo numerico, e un test sul fatto che il valore sia null o del tutto assente.
Un selettore malformato viene rifiutato quando salvi, non alle tre del mattino. Il selettore viene compilato in fase di validazione, quindi un errore di battitura in un JSONPath o in un XPath è un errore sul modulo invece che un monitor che fallisce silenziosamente - o passa silenziosamente - fin da quando lo hai creato.
Ogni guasto in questa tabella restituisce HTTP 200. È l'intero problema del monitorare un'API basandosi solo sul codice di stato: il trasporto è riuscito, quindi il trasporto segnala successo.
| Cosa è andato storto | Come appare la risposta | Cosa lo intercetta |
|---|---|---|
| Una pagina di errore viene servita dove dovrebbe esserci un payload | 200, con HTML | Una verifica sul content type, o una regola che il corpo si analizzi come JSON |
| L'indice di ricerca ha smesso di ricostruirsi | 200, con un array di risultati vuoto | Una regola che il conteggio dei risultati sia almeno uno |
| Un campo è stato rinominato in una modifica dello schema | 200, JSON valido, membro mancante | Una regola che il campo esista |
| Un rilascio è stato riportato indietro senza che nessuno se ne accorgesse | 200, stringa di versione più vecchia | Una regola che blocca il campo versione |
| Un membro di errore compare dentro un involucro di successo | 200, con un membro di errore impostato | Una regola che il membro di errore sia assente |
| Una dipendenza a valle sta fallendo e l'API si degrada in modo controllato | 200, con dati parziali o non aggiornati | Una regola sul campo di salute proprio dell'API, o un valore di freschezza nel payload |
| L'endpoint ora risponde in quattro secondi invece che in duecento millisecondi | 200, alla fine | Una regola sul tempo di risposta |
| L'autenticazione ha smesso silenziosamente di essere applicata | 200, restituendo dati che non dovrebbe | Un monitor negativo dedicato - una richiesta non autenticata che deve restituire 401 |
Quell'ultima riga vale la pena farla deliberatamente. Un secondo monitor che non invia credenziali e verifica un 401 è il modo più economico per scoprire che un livello di autorizzazione è stato disattivato per errore - un guasto che nessuna quantità di test positivi farà mai emergere.
I monitor API vengono eseguiti dalla rete pubblica di postazioni di HostTracker - oltre 300 postazioni in 158 città - e tu scegli quali località utilizza un dato monitor. La geografia conta di più per un'API che per un sito web: un endpoint dietro una CDN o un load balancer con instradamento geografico può essere sano a Francoforte e in errore a San Paolo, e un controllo da una sola postazione non ha modo di vederlo. Lo stesso vale per il DNS - un record obsoleto o configurato male spesso si propaga in modo irregolare, il che appare come un'interruzione intermittente dall'interno e come un'interruzione regionale dall'esterno.
Eseguire il controllo da molti luoghi comporta un rischio evidente: più postazioni, più occasioni per un singolo percorso di rete instabile di gridare al lupo. HostTracker gestisce questo con un quorum di conferma. Quando una postazione segnala un fallimento, il controllo viene ripetuto su ulteriori postazioni indipendenti e il cambio di stato viene confermato solo quando concordano - per impostazione predefinita un verdetto a maggioranza su un massimo di sette agenti, con un minimo di tre. Puoi renderlo più rigoroso, richiedendo che un numero fissato di agenti segnali il fallimento o il pieno accordo tra loro, per un endpoint dove un falso avviso è peggio di uno lento.
Dopo la conferma, l'invio degli avvisi segue il ritardo scelto da ciascun contatto - immediatamente, oppure dopo 3, 5, 15, 30 o 60 minuti, o 3, 6, 12 o 24 ore di guasto continuo - sui nove canali di notifica: email, SMS, chiamata vocale, webhook, Slack, e le app di messaggistica Telegram, Discord, Viber, Facebook Messenger e Google Chat. Il canale webhook è il modo in cui gli avvisi raggiungono uno strumento di gestione degli incidenti o di chat di team.
Il controllo è una richiesta HTTP configurabile più l'analisi della risposta, quindi ciò a cui si adatta segue direttamente da questo.
data - e vale la pena verificare che il membro errors sia assente, dato
che GraphQL è notoriamente capace di rispondere 200 con errori all'interno.Ciò che non si adatta è una sequenza - ottenere un token, usarlo, poi eliminare la risorsa. Un monitor API effettua una richiesta per esecuzione. Per un percorso genuinamente multi-fase, lo strumento giusto è il controllo transazionale guidato da browser; per i tempi di una pagina invece che di un endpoint, vedi tempistiche di accesso e caricamento pagina da browser.
Sono complementari e spesso confusi tra loro. Una piattaforma di osservabilità o APM strumenta il tuo codice e ti dice cosa è successo dentro una richiesta. Il monitoraggio API esterno sta fuori dalla tua infrastruttura e ti dice cosa riceve davvero un consumatore. Vale la pena avere entrambi; nessuno dei due sostituisce l'altro.
| Monitoraggio API esterno | APM / osservabilità | |
|---|---|---|
| Punto di osservazione | Fuori dalla tua infrastruttura, sull'internet pubblica | Dentro il processo della tua applicazione |
| Richiede modifiche al codice | No - non si installa nulla da nessuna parte | Un agente o SDK in ogni servizio |
| Vede problemi di DNS, instradamento, TLS e CDN | Sì - sono sul percorso che compie | No - accadono prima che la richiesta arrivi |
| Continua a segnalare quando l'intera piattaforma è giù | Sì - non è ospitato da te | Spesso no - anche ciò che segnala è giù |
| Spiega perché una richiesta è stata lenta dentro il tuo codice | No - vede la scomposizione dei tempi, non il tuo stack | Sì - è esattamente il suo scopo |
| Copre un endpoint che nessuno ha chiamato oggi | Sì - lo chiama secondo una pianificazione | No - senza traffico, nessuna telemetria |
Lo schema su cui si stabilizzano la maggior parte dei team è monitoraggio esterno per il rilevamento e telemetria interna per la diagnosi: HostTracker ti dice che un endpoint si è rotto, da dove e contro quale regola, e il tuo tracing ti dice perché. Accanto a esso, un monitor delle query al database spesso spiega un'API diventata lenta, e il monitoraggio del carico server spiega la macchina su cui gira.
Uno strumento di monitoraggio API invia richieste ai tuoi endpoint secondo una pianificazione e valuta la risposta rispetto a regole che tu stesso definisci, invece di limitarsi a confermare che il server abbia risposto. Il monitoraggio API di HostTracker verifica prima che l'endpoint sia raggiungibile e restituisca il codice di stato HTTP atteso, poi controlla che il content type della risposta corrisponda a quanto previsto (JSON, XML, testo semplice e così via), e infine cerca all'interno del corpo della risposta i valori o i pattern specifici che hai configurato. Questo approccio a più livelli individua problemi che un semplice controllo "è online" non riuscirebbe mai a rilevare - un endpoint può restituire un normale codice 200 pur inviando dati corrotti, incompleti o obsoleti a causa di un bug nel backend, di una query al database fallita o di un'integrazione a valle interrotta. Definire policy di validazione chiare fin dall'inizio permette al monitor di sapere esattamente com'è fatta una risposta sana per la tua specifica API.
Il monitoraggio dell'uptime di un sito web verifica in genere se una pagina si carica e restituisce un codice di stato HTTP normale, il che funziona bene per pagine pensate per essere visualizzate in un browser. Il monitoraggio API va oltre, perché le API vengono consumate da altro codice, non da persone, quindi una risposta "funzionante" deve soddisfare requisiti più rigidi: il content type corretto, una struttura valida e i valori giusti all'interno del payload, non solo un codice di stato positivo. Un endpoint può restituire HTTP 200 mentre i dati effettivi sono sbagliati, mancanti o malformati, e i controlli di uptime tradizionali da soli non se ne accorgono, perché guardano solo il codice di risposta. Il monitoraggio API di HostTracker controlla entrambi i livelli - raggiungibilità e codice di stato, come fa il monitoraggio dell'uptime, più la validazione del content type e la ricerca dei valori attesi nel corpo della risposta - offrendo un quadro molto più accurato del reale funzionamento di un'API.
Sì, è proprio questo che distingue il monitoraggio API da un semplice controllo di uptime. HostTracker ti permette di impostare policy di validazione che vanno oltre la semplice conferma che l'endpoint abbia risposto: puoi specificare il content type atteso, in modo che un check fallisca se un endpoint inizia inaspettatamente a restituire HTML invece di JSON (un sintomo comune di una pagina di errore servita al posto dei dati reali), e puoi cercare all'interno del contenuto della risposta valori specifici che devono essere presenti perché la risposta sia considerata sana. Questo significa che un check può fallire anche quando il codice di stato HTTP appare perfettamente normale, individuando i casi in cui un bug nel backend o un'integrazione a valle interrotta produce una risposta tecnicamente riuscita ma funzionalmente sbagliata. Validare il contenuto reale, non solo la connettività, è ciò che rende il monitoraggio API davvero significativo per gli endpoint da cui dipendono altri sistemi.
Dopo aver confermato che un endpoint risponde e che il suo content type corrisponde a quanto atteso, il monitoraggio API di HostTracker cerca all'interno del contenuto restituito i valori o i pattern testuali specifici che hai configurato come parte della policy di validazione del check. Questo ti permette di confermare che una risposta contiene un determinato campo, un valore di stato o un dato che indica che l'endpoint funziona correttamente - ad esempio, verificando che la risposta di un endpoint di health-check includa il valore di stato atteso invece di un messaggio di errore incapsulato in una risposta 200. Se il contenuto atteso non viene trovato, il check viene segnato come fallito anche se la connessione stessa è riuscita, e vieni avvisato attraverso i tuoi canali di notifica configurati. Questo tipo di controllo consapevole del contenuto è particolarmente utile per individuare i guasti parziali, in cui un'API è tecnicamente raggiungibile ma restituisce silenziosamente dati incompleti o errati.
La frequenza dei controlli è configurabile, e i piani a pagamento di HostTracker supportano intervalli fino a un minuto su tutte le tipologie di monitoraggio, così gli endpoint API critici per l'uptime della tua applicazione possono essere controllati in modo quasi continuo. Il piano gratuito permanente esegue i controlli ogni 30 minuti su un massimo di due monitor, una frequenza ragionevole per API di priorità più bassa o a uso interno, dove un breve ritardo nel rilevare un problema non ha un costo elevato. Per le API critiche per il business - quelle che alimentano un'applicazione live, un flusso di pagamento o un'integrazione da cui dipendono i tuoi clienti - intervalli più brevi significano che i problemi vengono rilevati e risolti prima che si trasformino in un'interruzione più ampia, percepibile dagli utenti. Una prova gratuita di 30 giorni con tutte le funzionalità, controlli a 1 minuto e senza carta di credito ti permette di testare quanto velocemente devi rilevare i problemi per la tua specifica API.
Sì. Un monitor API può inviare tutto ciò che l'endpoint richiede per accettare la richiesta: intestazioni personalizzate arbitrarie - il modo in cui si fornisce un bearer token, un'intestazione con chiave API o un identificativo di tenant - oltre a un nome utente e una password per l'autenticazione HTTP, un corpo della richiesta per POST, PUT o PATCH, e qualsiasi metodo HTTP da GET e HEAD fino a POST, PUT, PATCH e DELETE. Il consiglio pratico è lo stesso valido per qualsiasi client automatizzato: emetti per il monitor una credenziale propria invece di riutilizzare quella di una persona, dagli l'ambito più ristretto che comunque metta alla prova l'endpoint in modo significativo, e preferisci un endpoint di sola lettura o una route di health dedicata rispetto a qualsiasi cosa modifichi dati. Se i tuoi token hanno vita breve, punta il monitor verso un endpoint la cui autenticazione non scade - una route di health o status protetta da una chiave a lunga durata - invece di cercare di far eseguire al monitor uno scambio di token che non ha modo di effettuare.
I controlli API vengono eseguiti a un intervallo che va da un minuto fino a 24 ore - 1, 2, 3, 5, 10, 15, 30 e 45 minuti, poi 1, 2, 4, 6, 12 e 24 ore - e un nuovo monitor ha come impostazione predefinita tre minuti. Vengono eseguiti dalla rete pubblica di postazioni di HostTracker, che copre oltre 300 postazioni in 158 città, e tu scegli quali località utilizza un dato monitor. Eseguire il controllo da più regioni conta di più per un'API che per un sito web: un endpoint dietro una CDN o un load balancer con instradamento geografico può essere perfettamente sano in una regione e in errore in un'altra, e un controllo da una sola postazione semplicemente non può vederlo. Questo guida anche il controllo dei falsi allarmi - quando una postazione segnala un fallimento, il controllo viene ripetuto da altre postazioni indipendenti e il cambio di stato viene confermato solo quando il quorum concorda, così un singolo percorso di rete instabile tra un data center e il tuo host non avvisa nessuno.
Entrambi. Per un test una tantum, il controllo HTTP gratuito esegue il tuo endpoint da oltre 300 località in questo momento, senza bisogno di un account. Un monitor API è la stessa richiesta ripetuta secondo una pianificazione, anche ogni minuto, con le tue regole di validazione applicate a ogni risposta e un avviso nel momento in cui una di esse fallisce. La maggior parte dei team inizia con il controllo per vedere cosa riporta una località, e poi aggiunge il monitor per gli endpoint da cui dipendono i propri clienti o le proprie integrazioni.
Quando un check di monitoraggio API fallisce - perché l'endpoint non ha risposto, ha restituito un content type inatteso o non conteneva i valori richiesti dalla tua policy di validazione - HostTracker invia un avviso attraverso uno dei suoi 9 canali di notifica configurati, tra cui email, SMS, chiamata vocale, webhook, Slack e app di messaggistica come Telegram, Discord e Viber. Questo permette al tuo team di scoprire un'API guasta o degradata nel momento stesso in cui viene rilevata, invece che tramite un ticket di supporto dopo che l'integrazione ha già fallito silenziosamente per ore. Poiché il check valuta sia la raggiungibilità che il contenuto, l'avviso riflette un problema funzionale reale dell'API e non un semplice intoppo di connettività, il che aiuta a evitare sia incidenti mancati sia notifiche superflue.
Avvia una prova gratuita e ricevi un avviso nel momento esatto in cui un endpoint restituisce lo stato sbagliato, viola il proprio contratto o rallenta.
Fa parte del software di monitoraggio siti web di HostTracker.