
REST y GraphQL
Cualquier método, cabeceras personalizadas, un cuerpo y autenticación - y reglas sobre el JSON que vuelve.
Monitoreo de API
La herramienta de monitorización de API de HostTracker comprueba el uptime, el tiempo de respuesta y el payload de tus endpoints desde 300+ ubicaciones, según reglas que escribes en lenguaje sencillo - un código de estado, un campo JSON, un tiempo de respuesta - y te alerta en el momento en que una llamada deja de cumplirlas.
Cómo se ejecuta una comprobación de API
Las reglas leen la respuesta y comparan. Juntas, estas cuatro cubren las capas que importan.
api.example.com/v1/orders · 4 reglas · superado
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Consultas estructuradas en JSON, XML, HTML o YAML; la cadena de redirecciones paso a paso; el protocolo TLS y el cifrado negociados.
Compare esta ejecución con la anterior: un contador que nunca retrocede, un hash del cuerpo que no debe cambiar.
JSONPath, XPath o una expresión regular selecciona un valor; igual, rango, pertenencia a una lista o nulo decide.
Más informaciónLa solicitud con la forma que el endpoint espera, las reglas sobre lo que vuelve.
Cualquier método, cabeceras personalizadas, un cuerpo y autenticación - y reglas sobre el JSON que vuelve.
Analice el cuerpo como XML y seleccione con XPath. El sobre es solo otra respuesta.
Envíe un contenido según un horario y verifique el acuse de recibo, de modo que un receptor silencioso se detecte antes de que lo note un socio.
HostTracker comprueba tus endpoints de API de forma programada, validando el código de estado, el tipo de contenido y los valores dentro de la respuesta, no solo si el servidor responde.
Monitorear tus APIs es fundamental. Te ayuda a controlar su rendimiento, su disponibilidad y si están haciendo lo que deben hacer. También garantiza que cumplan con los estándares de rendimiento, lo que te ayuda a evitar posibles problemas
El monitoreo de uptime consiste básicamente en comprobar un endpoint de API a intervalos regulares para asegurarte de que esté disponible cuando lo necesites y funcione bien. El monitoreo de rendimiento, en cambio, mide con qué rapidez y fiabilidad responde una API a las solicitudes.
El buen funcionamiento de las APIs puede tener un gran impacto en la experiencia de los usuarios con las aplicaciones, en su rendimiento general e incluso en los resultados financieros del negocio.
El valor que extrae una regla se almacena por comprobación y se representa junto al tiempo de respuesta y la velocidad.
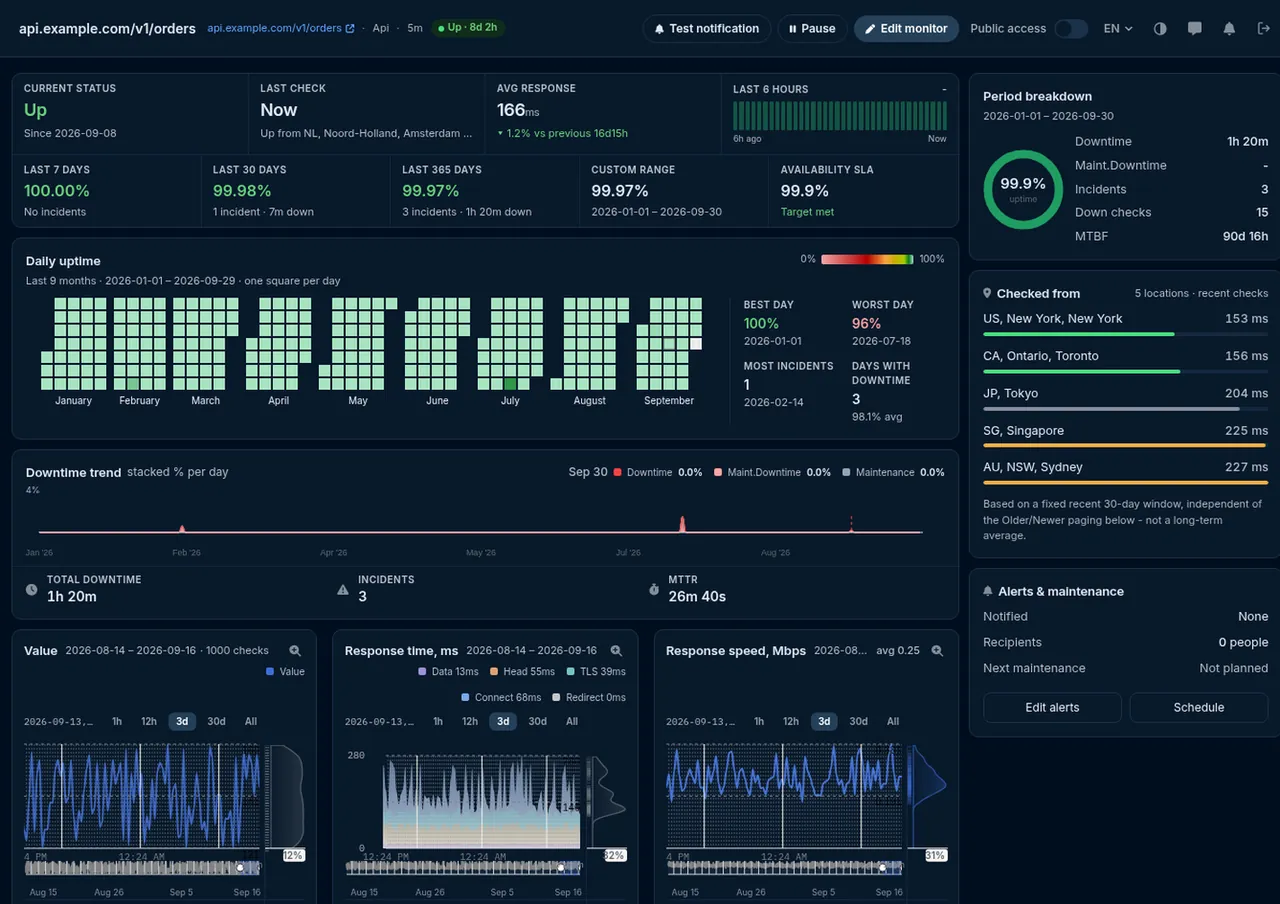
body.json.path("$.count") se convierte en una serie. Una caída a cero es visible antes de convertirse en una alerta.
Tiempo de conexión, TLS, cabeceras y datos por comprobación, desde cada ubicación que elija.
Sitios web, servidores, APIs, certificados. Un tipo de comprobación por página, con las mismas ubicaciones, alertas e informes detrás.
"Llevo mucho tiempo trabajando con este servicio de monitorización, y mi rutina diaria ya no es un problema. Vigila silenciosamente todos mis sitios y me permite reaccionar en cuanto algo falla."
Con la confianza de equipos en
Cada capítulo se abre en su lugar, para que la página siga siendo breve.
El monitoreo de API REST se parece superficialmente al monitoreo de uptime y es un trabajo distinto. Una API la consume código, no personas, y el código es implacable de formas en que un navegador no lo es. Un visitante humano tolera una página que se renderiza ligeramente mal; una integración que recibe un campo del tipo equivocado simplemente se rompe. Así que el monitoreo de API tiene que verificar más capas que "¿respondió el servidor?", y HostTracker las verifica en orden, fallando en la primera que no se cumple.
| Capa | Qué se verifica | El fallo que detecta |
|---|---|---|
| 1 · Accesibilidad | El DNS resuelve, la conexión TCP se abre, el handshake TLS se completa | El endpoint desapareció, el certificado expiró, el host es inalcanzable desde parte del mundo |
| 2 · Estado | El código de estado HTTP, contra los códigos que aceptas o tratas explícitamente como errores | Un 500 tras una implementación, un 401 por una credencial expirada, un 429 que no esperabas |
| 3 · Tiempo | Tiempo de respuesta total, y su desglose entre conexión, TLS, cabeceras y cuerpo | Un endpoint que sigue funcionando pero silenciosamente pasó de 200 ms a cuatro segundos |
| 4 · Forma | Tipo de contenido y cabeceras - ¿esto es realmente JSON, o una página de error HTML disfrazada de 200? | Una página de error o una redirección de login servida donde debería haber un payload. El clásico fallo silencioso de API |
| 5 · Contenido | Un valor seleccionado del payload, o aserciones libres sobre toda la respuesta | Un campo ausente tras un cambio de esquema, un conjunto de resultados vacío, una cadena de versión que retrocedió, un miembro de error que aparece dentro de una respuesta exitosa |
Las capas uno a tres son lo que te da una comprobación de uptime común. La cuatro y la cinco son lo que convierte esto en monitoreo de API - y son las capas donde realmente viven la mayoría de los incidentes reales de API.
Antes de que se pueda validar nada, el monitor tiene que hacer la solicitud que tu API espera. La superficie completa de solicitud está disponible en un monitor de API:
| Ajuste | Qué puedes hacer con él |
|---|---|
| Método HTTP | GET, HEAD, POST, PUT, PATCH o DELETE |
| Cabeceras personalizadas | Cualquier par nombre/valor que necesites - un token bearer, una clave de API, un identificador de tenant, una cabecera de versión Accept. Las cabeceras se reenvían solo al mismo host a través de una redirección, así que una credencial nunca se filtra a un tercero al que rebote tu endpoint. |
| Cuerpo de la solicitud | Un cuerpo sin procesar para POST, PUT y PATCH, o parámetros codificados como formulario |
| Autenticación HTTP | Un usuario y contraseña, con el esquema que pida el servidor negociado en la conexión |
| Redirecciones | Seguirlas o no, limitar cuántas se siguen, o tratar cualquier redirección como un fallo - útil para un endpoint que debe responder directamente |
| Tiempo de espera | Hasta 100 segundos, con 40 por defecto - y un tiempo de espera agotado es un fallo de la verificación, que es exactamente lo que quieres de un endpoint con un SLA |
| Límite de tamaño de la respuesta | 1 MB por defecto y se puede aumentar, para que una respuesta desbocada no consuma la comprobación |
| Códigos de estado aceptados y rechazados | Listas de códigos a ignorar, y códigos a tratar como errores - la herramienta para un endpoint que legítimamente responde 401 o 404 como parte de su contrato |
| Control de DNS | Resolver a través de resolvers específicos, saltarse la caché DNS del punto de verificación, y verificar a qué direcciones IP resuelve el host |
| Rigor TLS | Optar por exigir una cadena de certificado válida, TLS 1.2 o superior, cifrados por encima de 128 bits, y una verificación de revocación - más la vigilancia de expiración de certificado en la misma conexión |
La forma más expresiva de validar una respuesta es escribirle reglas. Cada regla es una línea, las reglas se combinan con AND, y un monitor puede llevar hasta veinte de ellas. Este es el paquete inicial verificado para una API JSON:
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Cuatro líneas, y entre ellas cubren las cuatro capas que importan: el endpoint respondió con un 2xx,
respondió con JSON en lugar de una página de error, el payload contiene un resultado real en lugar de uno
vacío, y lo hizo todo dentro del presupuesto. Reglas individuales útiles del mismo catálogo incluyen
body.json.path("$.status") eq "ok" para el propio veredicto de salud de una API,
body.json.path("$.error") absent para un miembro de error que aparece en una respuesta por lo
demás exitosa, body.json.path("$.version") eq "2.4.1" para detectar un retroceso no
intencionado, redirects.count eq 0 para un endpoint que debe responder directamente, y
cert.days.left gt 14 para el certificado de la misma conexión.
Las reglas leen sujetos de la respuesta y los comparan. Los sujetos cubren el código de estado; el tiempo
de respuesta total y sus componentes de conexión, TLS, DNS, cabeceras y cuerpo; el cuerpo sin procesar
junto con su tamaño y un hash del mismo; consultas estructuradas dentro del payload como JSON, XML, HTML o
YAML; cabeceras de respuesta individuales; la URL final y la original y sus partes; la cadena de
redirecciones, salto por salto; los días restantes, el emisor y los nombres del certificado; el protocolo
y el cifrado TLS negociados; las direcciones que devolvió el DNS; y Set-Cookie. Las
comparaciones van desde lo obvio - igual, menor que, mayor que - hasta contains,
startsWith, endsWith, matches para una expresión regular,
containsAny y containsAll para un conjunto, in para una lista de
valores aceptables, y exists, isNumber y unique.
También hay un eje de detección de cambios: una regla puede comparar el valor de esta ejecución con el de la anterior, así que puedes verificar que un contador nunca retrocede o que un hash del cuerpo no ha cambiado - la forma de regla que detecta un retroceso silencioso o un cambio de contenido no autorizado en lugar de una caída.
Junto al lenguaje de reglas hay un camino más simple, de un solo valor, que ha formado parte del monitoreo de API aquí desde hace mucho tiempo y a menudo es todo lo que necesita una comprobación. Le dices al monitor cómo interpretar el cuerpo, cómo seleccionar un valor de él, y qué debe ser ese valor:
El predicado aplicado al valor seleccionado cubre igual y distinto, menor-que y mayor-que en sus formas estricta e inclusiva, pertenencia a una lista de valores aceptables o exclusión de ella, dentro de un rango numérico o fuera de él, y una prueba de que el valor sea nulo o esté ausente por completo.
Un selector mal formado se rechaza al guardar, no a las tres de la madrugada. El selector se compila en el momento de la validación, así que un error de tipeo en un JSONPath o un XPath es un error en el formulario en lugar de un monitor que ha estado fallando en silencio - o pasando en silencio - desde que lo creaste.
Cada fallo en esta tabla devuelve HTTP 200. Ese es todo el problema de monitorear una API solo por su código de estado: el transporte tuvo éxito, así que el transporte reporta éxito.
| Qué salió mal | Cómo se ve la respuesta | Qué lo detecta |
|---|---|---|
| Se sirve una página de error donde debería haber un payload | 200, con HTML | Una aserción de tipo de contenido, o una regla de que el cuerpo se interprete como JSON |
| El índice de búsqueda dejó de reconstruirse | 200, con un array de resultados vacío | Una regla de que el conteo de resultados sea al menos uno |
| Un campo se renombró en un cambio de esquema | 200, JSON válido, miembro ausente | Una regla de que el campo exista |
| Se revirtió una implementación sin que nadie lo notara | 200, cadena de versión anterior | Una regla que fija el campo de versión |
| Un miembro de error aparece dentro de un sobre de éxito | 200, con un miembro de error establecido | Una regla de que el miembro de error esté ausente |
| Una dependencia aguas abajo está fallando y la API se degrada de forma controlada | 200, con datos parciales o obsoletos | Una regla sobre el propio campo de salud de la API, o un valor de frescura en el payload |
| El endpoint ahora responde en cuatro segundos en vez de doscientos milisegundos | 200, eventualmente | Una regla de tiempo de respuesta |
| La autenticación dejó de aplicarse silenciosamente | 200, devolviendo datos que no debería | Un monitor negativo dedicado - una solicitud sin credenciales que debe devolver 401 |
Esa última fila vale la pena hacerla de forma deliberada. Un segundo monitor que no envía credenciales y verifica un 401 es la forma más barata de descubrir que una capa de autorización se desactivó por accidente - un fallo que ninguna cantidad de pruebas positivas hará salir a la superficie jamás.
Los monitores de API se ejecutan desde la flota pública de puntos de verificación de HostTracker - más de 300 puntos de verificación en 158 ciudades -, y tú eliges qué ubicaciones usa un monitor determinado. La geografía importa más para una API que para un sitio web: un endpoint servido por una CDN o un balanceador de carga geo-enrutado puede estar saludable en Fráncfort y fallando en São Paulo, y una comprobación de una sola ubicación no tiene forma de verlo. Lo mismo ocurre con el DNS - un registro obsoleto o mal configurado a menudo se propaga de forma desigual, lo que se ve como una caída intermitente desde dentro y como una caída regional desde fuera.
Ejecutarse desde muchos lugares plantea un riesgo obvio: más puntos de verificación, más oportunidades de que una ruta de red inestable dé falsas alarmas. HostTracker maneja eso con un quórum de confirmación. Cuando un punto de verificación reporta un fallo, la comprobación se repite en puntos de verificación independientes adicionales y el cambio de estado solo se confirma una vez que están de acuerdo - por defecto un veredicto por mayoría entre hasta siete agentes, con un mínimo de tres. Puedes hacerlo más estricto, exigiendo un número determinado de agentes que reporten el fallo o el acuerdo total entre ellos, para un endpoint donde una falsa alarma es peor que una lenta.
Tras la confirmación, la alerta sigue el retraso que cada contacto eligió - inmediatamente, o después de 3, 5, 15, 30 o 60 minutos, o de 3, 6, 12 o 24 horas de fallo continuo - a través de los nueve canales de notificación: correo electrónico, SMS, llamada de voz, webhook, Slack y las apps de mensajería Telegram, Discord, Viber, Facebook Messenger y Google Chat. El canal de webhook es la forma en que las alertas llegan a un gestor de incidentes o a una herramienta de chat de equipo.
La comprobación es una solicitud HTTP configurable más un análisis de la respuesta, así que lo que encaja se deriva directamente de eso.
data - y vale la pena verificar que el miembro errors esté ausente, ya que
GraphQL es famoso por responder 200 con errores dentro.Lo que no encaja es una secuencia - obtener un token, usarlo, luego eliminar el recurso. Un monitor de API hace una solicitud por ejecución. Para un recorrido genuino de varios pasos, la verificación de transacción impulsada por navegador es la herramienta; para el tiempo de una página en lugar de un endpoint, mira el monitoreo de tiempos de carga en navegador.
Son complementarios y con frecuencia se confunden. Una plataforma de observabilidad o APM instrumenta tu código y te dice qué pasó dentro de una solicitud. El monitoreo de API externo se mantiene fuera de tu infraestructura y te dice qué recibe realmente un consumidor. Vale la pena tener ambos; ninguno sustituye al otro.
| Monitoreo de API externo | APM / observabilidad | |
|---|---|---|
| Punto de vista | Fuera de tu infraestructura, por internet público | Dentro del proceso de tu aplicación |
| Requiere cambios de código | No - no se instala nada en ningún lugar | Un agente o SDK en cada servicio |
| Ve problemas de DNS, enrutamiento, TLS y CDN | Sí - están en la ruta que recorre | No - ocurren antes de que llegue la solicitud |
| Sigue reportando cuando toda la plataforma está caída | Sí - no está alojado por ti | A menudo no - lo que reporta también está caído |
| Explica por qué una solicitud fue lenta dentro de tu código | No - ve el desglose de tiempos, no tu stack | Sí - ese es todo su propósito |
| Cubre un endpoint que nadie llamó hoy | Sí - lo llama según un horario | No - sin tráfico, sin telemetría |
El patrón en el que se asientan la mayoría de los equipos es monitoreo externo para la detección y telemetría interna para el diagnóstico: HostTracker te dice que un endpoint se rompió, desde dónde y contra qué regla, y tu propio trazado te dice por qué. Junto a él, un monitor de consultas de base de datos a menudo explica una API que se volvió lenta, y el monitoreo de carga de servidor explica el host sobre el que corre.
Una herramienta de monitoreo de API envía solicitudes a tus endpoints según un horario programado y evalúa la respuesta frente a las reglas que tú defines, en lugar de limitarse a confirmar que el servidor respondió. El monitoreo de API de HostTracker primero verifica que el endpoint sea accesible y devuelva el código de estado HTTP esperado, después comprueba que el tipo de contenido de la respuesta coincida con lo esperado (JSON, XML, texto plano, etc.) y, por último, busca dentro del cuerpo de la respuesta los valores o patrones específicos que hayas configurado. Este enfoque por capas detecta problemas que una simple comprobación de "¿está activo?" pasaría totalmente por alto: un endpoint puede devolver un código 200 normal y aun así entregar datos corruptos, incompletos o desactualizados debido a un error en el backend, una consulta fallida a la base de datos o una integración rota más adelante en la cadena. Definir políticas de validación claras desde el principio permite que el monitor sepa cómo es realmente una respuesta saludable para tu API específica.
El monitoreo de disponibilidad de un sitio web (uptime) normalmente comprueba si una página carga y devuelve un código de estado HTTP normal, lo cual funciona bien para páginas pensadas para verse en un navegador. El monitoreo de API va más allá porque las APIs las consume código, no personas, así que una respuesta "correcta" debe cumplir requisitos más estrictos: el tipo de contenido adecuado, una estructura válida y los valores correctos dentro del payload, no solo un código de estado exitoso. Un endpoint puede devolver HTTP 200 mientras los datos reales son incorrectos, faltan o están mal formados, y las comprobaciones de uptime tradicionales por sí solas no detectan eso porque solo miran el código de respuesta. El monitoreo de API de HostTracker comprueba ambas capas - accesibilidad y código de estado, igual que el monitoreo de uptime -, además de validar el tipo de contenido y buscar los valores esperados dentro del cuerpo de la respuesta, ofreciendo una imagen mucho más precisa de si una API realmente funciona correctamente.
Sí, eso es precisamente lo que distingue al monitoreo de API de una simple comprobación de uptime. HostTracker te permite definir políticas de validación que van más allá de confirmar que el endpoint respondió: puedes especificar el tipo de contenido esperado para que la comprobación falle si un endpoint empieza a devolver HTML en lugar de JSON de forma inesperada (un síntoma habitual de que se está sirviendo una página de error en vez de datos reales), y puedes buscar dentro del contenido de la respuesta valores específicos que deben estar presentes para que se considere saludable. Esto significa que una comprobación puede fallar incluso cuando el código de estado HTTP parece perfectamente normal, detectando casos en los que un error del backend o una integración rota más adelante produce una respuesta técnicamente exitosa pero funcionalmente incorrecta. Validar el contenido real, no solo la conectividad, es lo que hace que el monitoreo de API tenga sentido para los endpoints de los que dependen otros sistemas.
Después de confirmar que un endpoint responde y que su tipo de contenido coincide con lo esperado, el monitoreo de API de HostTracker busca dentro del contenido devuelto los valores específicos o patrones de texto que hayas configurado como parte de la política de validación de la comprobación. Esto te permite confirmar que una respuesta contiene un campo concreto, un valor de estado o un dato que indica que el endpoint funciona correctamente; por ejemplo, verificar que la respuesta de un endpoint de health-check incluya el valor de estado esperado en lugar de un mensaje de error envuelto en una respuesta 200. Si no se encuentra el contenido esperado, la comprobación se marca como fallida aunque la conexión en sí haya tenido éxito, y recibes una alerta por los canales de notificación que hayas configurado. Este tipo de comprobación basada en el contenido es especialmente útil para detectar fallos parciales, en los que una API es técnicamente accesible pero devuelve silenciosamente datos incompletos o incorrectos.
La frecuencia de comprobación es configurable, y los planes de pago de HostTracker admiten intervalos de hasta una vez por minuto en todos sus tipos de monitoreo, por lo que los endpoints de API críticos para la disponibilidad de tu aplicación pueden comprobarse casi de forma continua. El plan gratuito permanente ejecuta comprobaciones cada 30 minutos en hasta dos monitores, una frecuencia razonable para APIs internas o de menor prioridad donde un pequeño retraso en detectar un problema no resulta costoso. Para APIs críticas para el negocio - las que impulsan una aplicación en producción, un flujo de pago o una integración de la que dependen tus clientes -, los intervalos más cortos permiten detectar y resolver los problemas antes de que se conviertan en una caída mayor que los usuarios lleguen a notar. Una prueba gratuita de 30 días con todas las funciones, comprobaciones cada 1 minuto y sin necesidad de tarjeta de crédito te permite comprobar qué tan rápida debe ser la detección para tu API específica.
Sí. Un monitor de API puede enviar lo que sea que el endpoint requiera para aceptar la solicitud: cabeceras personalizadas arbitrarias - la forma en que se proporciona un token bearer, una cabecera de clave de API o un identificador de tenant -, además de un usuario y contraseña para autenticación HTTP, un cuerpo de solicitud para POST, PUT o PATCH, y cualquier método HTTP desde GET y HEAD hasta POST, PUT, PATCH y DELETE. El consejo práctico es el mismo que para cualquier cliente automatizado: emite al monitor su propia credencial en lugar de reutilizar la de una persona, dale el alcance más estrecho que aun así ejercite el endpoint de forma significativa, y prefiere un endpoint de solo lectura o una ruta de salud dedicada antes que cualquier cosa que modifique datos. Si tus tokens tienen vida corta, apunta el monitor a un endpoint cuya autenticación no caduque - una ruta de salud o estado protegida por una clave de vida larga -, en lugar de intentar que el monitor realice un intercambio de tokens que no tiene forma de hacer.
Las comprobaciones de API se ejecutan en un intervalo de un minuto hasta 24 horas - 1, 2, 3, 5, 10, 15, 30 y 45 minutos, luego 1, 2, 4, 6, 12 y 24 horas -, y un monitor nuevo usa tres minutos por defecto. Se ejecutan desde la flota pública de puntos de verificación de HostTracker, que abarca más de 300 puntos de verificación en 158 ciudades, y tú eliges qué ubicaciones usa un monitor determinado. Ejecutarse desde varias regiones importa más para una API que para un sitio web: un endpoint servido por una CDN o un balanceador de carga geo-enrutado puede estar perfectamente saludable en una región y fallando en otra, y una comprobación de una sola ubicación simplemente no puede verlo. También impulsa el control de falsas alarmas: cuando un punto de verificación reporta un fallo, la comprobación se repite desde otros puntos de verificación independientes y el cambio de estado solo se confirma una vez que el quórum está de acuerdo, así que una ruta de red inestable entre un centro de datos y tu host no alerta a nadie.
Ambos. Para una prueba puntual, la comprobación HTTP gratuita ejecuta tu endpoint ahora mismo desde 300+ ubicaciones, sin cuenta. Un monitor de API es la misma solicitud repetida según una programación, hasta cada minuto, con tus reglas de validación aplicadas a cada respuesta y una alerta en cuanto una falla. La mayoría de los equipos empiezan con el comprobador para ver qué reporta una ubicación, y luego añaden el monitor para los endpoints de los que dependen sus clientes o integraciones.
Cuando falla una comprobación de monitoreo de API - ya sea porque el endpoint no respondió, devolvió un tipo de contenido inesperado o no contenía los valores que exige tu política de validación -, HostTracker envía una alerta a través de cualquiera de sus 9 canales de notificación configurados, incluyendo correo electrónico, SMS, llamada de voz, webhooks, Slack y aplicaciones de mensajería como Telegram, Discord y Viber. Esto permite que tu equipo se entere de una API rota o degradada en el momento en que se detecta, en lugar de enterarse a través de un ticket de soporte después de que la integración lleve horas fallando en silencio. Como la comprobación evalúa tanto la accesibilidad como el contenido, la alerta refleja un problema funcional real de la API y no solo una interrupción momentánea de conectividad, lo que ayuda a evitar tanto incidentes pasados por alto como avisos innecesarios.
Inicia una prueba gratuita y recibe una alerta en el momento en que un endpoint devuelva un estado incorrecto, incumpla su contrato o se ralentice.
Forma parte del software de monitorización web de HostTracker.