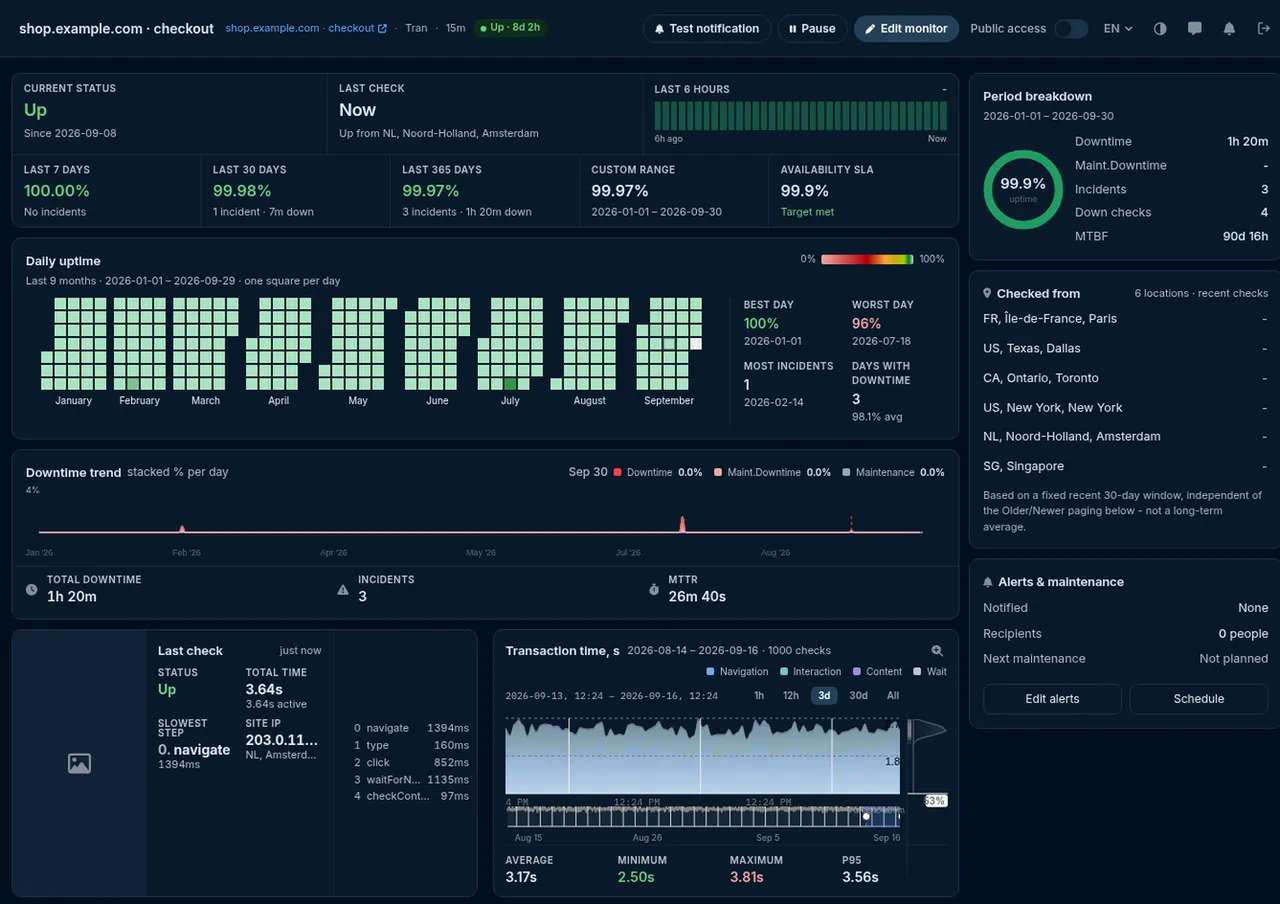
L’exécution s’arrête à l’étape en échec et enregistre ce qu’elle a constaté. Le résultat nomme
l’étape, classe l’échec - un délai dépassé, un élément que le sélecteur n’a pas pu résoudre, une
assertion de contenu non vérifiée, une erreur HTTP, une erreur de connexion, une erreur de console
du navigateur, ou une étape mal configurée - et conserve les durées par étape, l’URL, l’IP et le
statut HTTP sur lesquels chaque navigation a abouti, les messages de la console du navigateur, ainsi
qu’une capture d’écran de la page au moment de la panne.
Ce constat est ensuite recontrôlé avant que quiconque ne soit réveillé. Une seule
observation en échec n’est pas traitée comme une panne : la vérification est relancée depuis
d’autres points de contrôle indépendants, et le changement d’état n’est confirmé que lorsque le
quorum est d’accord. Par défaut, le verdict repose sur une majorité parmi jusqu’à sept agents, avec
un minimum de trois - de sorte qu’un point de contrôle instable, ou un incident réseau passager
entre un centre de données et votre hébergeur, ne peut pas déclencher une alerte à lui seul.
Une fois la transition confirmée, l’alerte suit le délai choisi par chaque contact : immédiatement,
ou seulement après 3, 5, 15, 30 ou 60 minutes, ou 3, 6, 12 ou 24 heures d’échec continu. Les alertes
sont envoyées via les neuf canaux de notification pris en charge par HostTracker - e-mail, SMS,
appel vocal, webhook, Slack, notification push et les messageries Telegram, Discord et Viber - et un
avis de rétablissement suit lorsque le parcours recommence à se terminer avec succès.