
REST e GraphQL
Qualquer método, cabeçalhos personalizados, um corpo e autenticação - e regras sobre o JSON que retorna.
Monitoramento de API
A ferramenta de monitoramento de API da HostTracker verifica o uptime, o tempo de resposta e o payload dos seus endpoints a partir de mais de 300 locais, de acordo com regras que você escreve em termos simples - um código de status, um campo JSON, um tempo de resposta - e alerta você no momento em que uma chamada deixa de corresponder a elas.
Como funciona uma verificação de API
As regras leem a resposta e comparam. Juntas, essas quatro cobrem as camadas que importam.
api.example.com/v1/orders · 4 regras · sucesso
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Consultas estruturadas em JSON, XML, HTML ou YAML; a cadeia de redirecionamentos passo a passo; o protocolo TLS e a cifra negociados.
Compare esta execução com a anterior: um contador que nunca retrocede, um hash do corpo que não pode mudar.
JSONPath, XPath ou uma expressão regular escolhe um valor; igualdade, intervalo, pertencimento a uma lista ou null decidem.
Saiba maisA requisição moldada como o endpoint espera, as regras sobre o que volta.
Qualquer método, cabeçalhos personalizados, um corpo e autenticação - e regras sobre o JSON que retorna.
Interprete o corpo como XML e selecione com XPath. O envelope é apenas mais uma resposta.
Envie um payload em um agendamento e valide a confirmação, para que um receptor silencioso seja detectado antes que um parceiro perceba.
A HostTracker verifica seus endpoints de API em intervalos programados, validando o código de status, o tipo de conteúdo e os valores dentro da resposta - não apenas se o servidor responde.
Monitorar suas APIs é fundamental. Isso ajuda você a acompanhar o desempenho, a disponibilidade e se elas estão funcionando como deveriam. Também garante que estejam atendendo aos padrões de performance, ajudando a evitar possíveis problemas
O monitoramento de uptime consiste basicamente em verificar um endpoint de API em intervalos regulares para garantir que ele esteja disponível quando você precisar e funcionando bem. Já o monitoramento de desempenho mede a rapidez e a confiabilidade com que uma API responde às solicitações.
O funcionamento das APIs tem um grande impacto na experiência dos usuários com os aplicativos, no desempenho geral e até nos resultados financeiros do negócio.
O valor que uma regra extrai é armazenado a cada verificação e plotado ao lado do tempo de resposta e da velocidade.
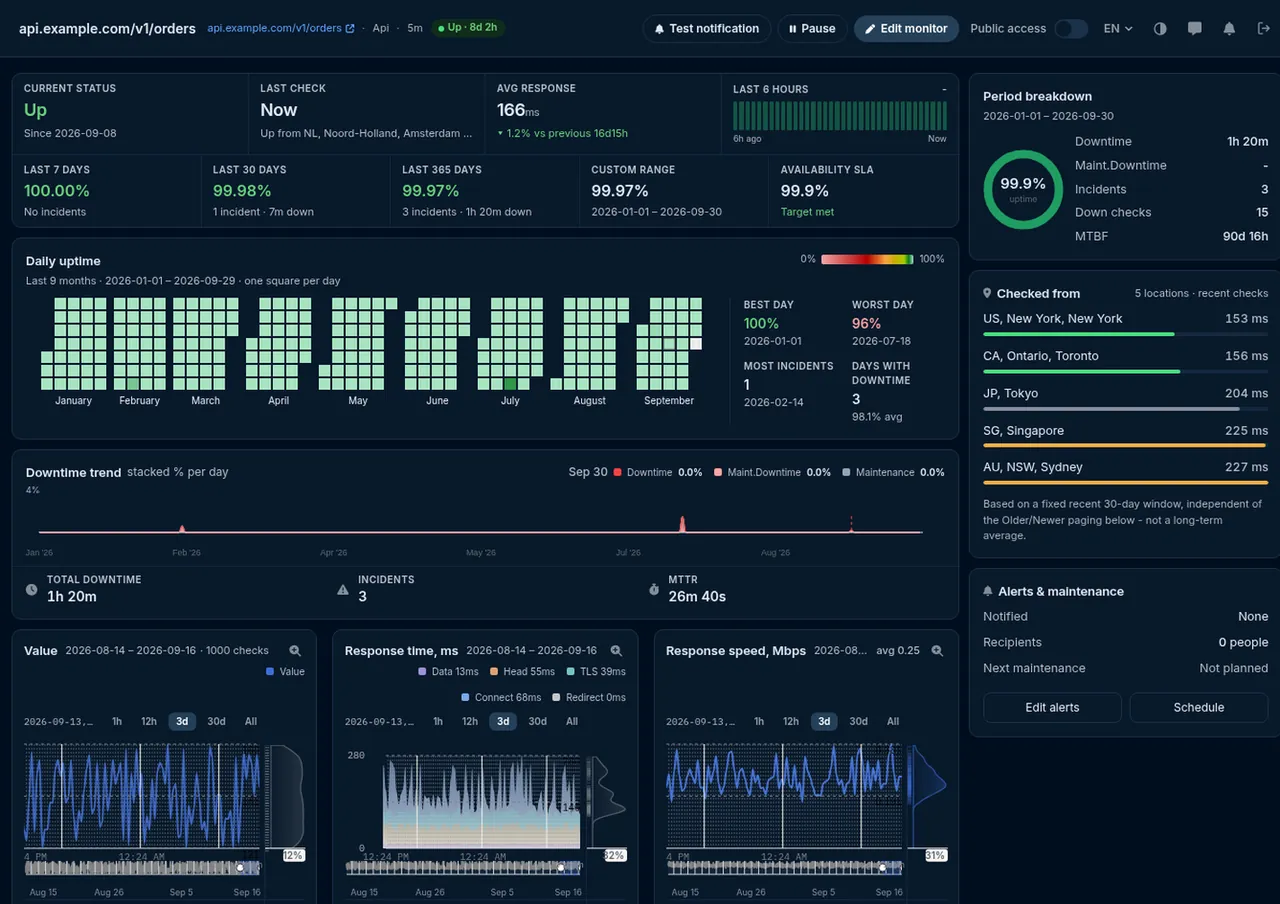
body.json.path("$.count") se torna uma série. Uma queda para zero fica visível antes de virar um alerta.
Tempo de conexão, TLS, cabeçalho e dados a cada verificação, de cada localização escolhida.
Sites, servidores, APIs, certificados. Um tipo de verificação por página, com as mesmas localidades, alertas e relatórios por trás.
"Uso este serviço de monitoramento há muito tempo, e minha rotina diária deixou de ser um problema. Ele observa todos os meus sites silenciosamente e me permite reagir no momento em que algo dá errado."
Confiado por equipes de
Cada capítulo abre no próprio lugar, para que a página continue curta.
O monitoramento de API REST parece superficialmente com o monitoramento de uptime, mas é um trabalho diferente. Uma API é consumida por código, não por pessoas, e código é implacável de formas que um navegador não é. Um visitante humano tolera uma página que renderiza um pouco errada; uma integração que recebe um campo do tipo errado simplesmente quebra. Por isso, o monitoramento de API precisa verificar mais camadas do que apenas "o servidor respondeu", e a HostTracker as verifica em ordem, falhando na primeira que não se sustenta.
| Camada | O que é verificado | A falha que ela detecta |
|---|---|---|
| 1 · Acessibilidade | O DNS resolve, a conexão TCP abre, o handshake TLS se completa | O endpoint sumiu, o certificado expirou, o host não é roteável a partir de parte do mundo |
| 2 · Status | O código de status HTTP, comparado aos códigos que você aceita ou trata explicitamente como erros | Um 500 após uma implantação, um 401 por uma credencial expirada, um 429 que você não esperava |
| 3 · Tempo | O tempo total de resposta, e sua divisão entre conexão, TLS, cabeçalhos e corpo | Um endpoint que ainda funciona, mas silenciosamente passou de 200 ms para quatro segundos |
| 4 · Formato | Tipo de conteúdo e cabeçalhos - isso é realmente JSON, ou uma página de erro em HTML disfarçada de 200 | Uma página de erro ou um redirecionamento de login servido onde deveria haver um payload. A clássica falha silenciosa de API |
| 5 · Conteúdo | Um valor selecionado dentro do payload, ou asserções livres sobre toda a resposta | Um campo ausente após uma mudança de schema, um conjunto de resultados vazio, uma string de versão que retrocedeu, um membro de erro aparecendo dentro de uma resposta bem-sucedida |
As camadas um a três são o que uma verificação de uptime comum oferece. A quatro e a cinco são o que faz disso monitoramento de API - e são as camadas onde a maioria dos incidentes reais de API realmente acontece.
Antes que qualquer coisa possa ser validada, o monitor precisa fazer a requisição que sua API espera. A superfície completa de requisição está disponível em um monitor de API:
| Configuração | O que você pode fazer com ela |
|---|---|
| Método HTTP | GET, HEAD, POST, PUT, PATCH ou DELETE |
| Cabeçalhos personalizados | Quaisquer pares de nome e valor que você precisar - um token bearer, uma chave de API, um identificador de tenant, um cabeçalho de versão Accept. Os cabeçalhos são encaminhados apenas para o mesmo host durante um redirecionamento, então uma credencial nunca vaza para um terceiro para o qual seu endpoint redireciona. |
| Corpo da requisição | Um corpo bruto para POST, PUT e PATCH, ou parâmetros codificados como formulário |
| Autenticação HTTP | Um usuário e senha, com o esquema que o servidor solicita negociado na conexão |
| Redirecionamentos | Segui-los ou não, limitar quantos são seguidos, ou tratar qualquer redirecionamento como uma falha - útil para um endpoint que precisa responder diretamente |
| Tempo limite | Até 100 segundos, com padrão de 40 - e um tempo limite é uma falha na verificação, que é exatamente o que você quer de um endpoint com SLA |
| Limite de tamanho da resposta | O padrão é 1 MB e pode ser aumentado, para que uma resposta descontrolada não consuma a verificação |
| Códigos de status aceitos e rejeitados | Listas de códigos a ignorar, e códigos a tratar como erros - a ferramenta para um endpoint que legitimamente responde 401 ou 404 como parte do seu contrato |
| Controle de DNS | Resolver através de resolvedores específicos, contornar o cache de DNS do checkpoint, e confirmar para quais endereços IP o host resolve |
| Rigor de TLS | Optar por exigir uma cadeia de certificado válida, TLS 1.2 ou superior, cifras acima de 128 bits, e uma verificação de revogação - além do acompanhamento de expiração de certificado na mesma conexão |
A forma mais expressiva de validar uma resposta é escrever regras para ela. Cada regra é uma linha, as regras são combinadas com AND, e um monitor pode carregar até vinte delas. Este é o pacote inicial verificado para uma API JSON:
status isOk
header("Content-Type") contains "json"
body.json.path("$.count") gt 0
time lt 5s
Quatro linhas, e juntas elas cobrem as quatro camadas que importam: o endpoint respondeu com um 2xx,
respondeu com JSON em vez de uma página de erro, o payload contém um resultado real em vez de um vazio,
e tudo isso dentro do orçamento de tempo. Regras individualmente úteis do mesmo catálogo incluem
body.json.path("$.status") eq "ok" para o próprio veredito de saúde de uma API,
body.json.path("$.error") absent para um membro de erro aparecendo em uma resposta que, de
outra forma, seria bem-sucedida, body.json.path("$.version") eq "2.4.1" para detectar um
retrocesso não intencional, redirects.count eq 0 para um endpoint que deve responder
diretamente, e cert.days.left gt 14 para o certificado na mesma conexão.
As regras leem sujeitos a partir da resposta e os comparam. Os sujeitos cobrem o código de status; o
tempo total de resposta e seus componentes de conexão, TLS, DNS, cabeçalho e corpo; o corpo bruto, junto
com seu tamanho e um hash dele; consultas estruturadas no payload como JSON, XML, HTML ou YAML;
cabeçalhos de resposta individuais; a URL final e a original e suas partes; a cadeia de
redirecionamentos, salto a salto; os dias restantes do certificado, o emissor e os nomes; o protocolo
TLS e a cifra negociados; os endereços que o DNS retornou; e o Set-Cookie. As comparações
vão do óbvio - igual, menor que, maior que - até contains, startsWith,
endsWith, matches para uma expressão regular, containsAny e
containsAll para um conjunto, in para uma lista de valores aceitáveis, e
exists, isNumber e unique.
Há também um eixo de detecção de mudanças: uma regra pode comparar o valor desta execução com o da execução anterior, então você pode confirmar que um contador nunca retrocede ou que um hash do corpo não mudou - o tipo de regra que detecta um retrocesso silencioso ou uma alteração de conteúdo não autorizada, em vez de uma queda.
Além da linguagem de regras, existe um caminho mais simples, de valor único, que já faz parte do monitoramento de API aqui há muito tempo e que, com frequência, é tudo que uma verificação precisa. Você diz ao monitor como interpretar o corpo, como selecionar um valor dentro dele, e o que esse valor deve ser:
O predicado aplicado ao valor selecionado cobre igual e diferente, menor-que e maior-que nas formas estrita e inclusiva, pertencimento a uma lista de valores aceitáveis ou exclusão dela, dentro de um intervalo numérico ou fora dele, e um teste para o valor ser nulo ou estar completamente ausente.
Um seletor malformado é rejeitado quando você salva, não às três da manhã. O seletor é compilado no momento da validação, então um erro de digitação em um JSONPath ou XPath é um erro no formulário, e não um monitor que vem falhando silenciosamente - ou passando silenciosamente - desde que você o criou.
Toda falha nesta tabela retorna HTTP 200. Esse é todo o problema de monitorar uma API apenas pelo código de status: o transporte teve sucesso, então o transporte reporta sucesso.
| O que deu errado | Como a resposta se parece | O que detecta isso |
|---|---|---|
| Uma página de erro é servida onde deveria haver um payload | 200, com HTML | Uma asserção de tipo de conteúdo, ou uma regra de que o corpo se interpreta como JSON |
| O índice de busca parou de ser reconstruído | 200, com um array de resultados vazio | Uma regra de que a contagem de resultados é pelo menos um |
| Um campo foi renomeado em uma mudança de schema | 200, JSON válido, membro ausente | Uma regra de que o campo existe |
| Uma implantação foi revertida sem que ninguém percebesse | 200, string de versão mais antiga | Uma regra fixando o campo de versão |
| Um membro de erro aparece dentro de um envelope de sucesso | 200, com um membro de erro definido | Uma regra de que o membro de erro está ausente |
| Uma dependência mais adiante está falhando e a API está se degradando graciosamente | 200, com dados parciais ou desatualizados | Uma regra sobre o próprio campo de saúde da API, ou um valor de atualidade no payload |
| O endpoint agora responde em quatro segundos em vez de duzentos milissegundos | 200, eventualmente | Uma regra de tempo de resposta |
| A autenticação parou de ser aplicada silenciosamente | 200, retornando dados que não deveria | Um monitor negativo dedicado - uma requisição sem autenticação que deve retornar 401 |
Essa última linha vale a pena fazer deliberadamente. Um segundo monitor que não envia credenciais e confirma um 401 é a forma mais barata de descobrir que uma camada de autorização foi desativada acidentalmente - uma falha que nenhuma quantidade de teste positivo jamais revelaria.
Os monitores de API são executados a partir da frota pública de checkpoints da HostTracker - mais de 300 checkpoints em 158 cidades - e você escolhe quais locais um determinado monitor usa. A geografia importa mais para uma API do que para um site: um endpoint atrás de uma CDN ou de um balanceador de carga geodistribuído pode estar saudável em Frankfurt e falhando em São Paulo, e uma verificação de local único não tem como ver isso. O mesmo vale para o DNS - um registro desatualizado ou mal configurado costuma se propagar de forma desigual, o que parece uma interrupção intermitente de dentro e uma regional de fora.
Executar a partir de muitos lugares traz um risco óbvio: mais checkpoints, mais chances de uma rota de rede instável dar um alarme falso. A HostTracker resolve isso com um quórum de confirmação. Quando um checkpoint relata uma falha, a verificação é repetida em checkpoints independentes adicionais, e a mudança de estado só é confirmada quando eles concordam - por padrão, um veredito por maioria entre até sete agentes, com um mínimo de três. Você pode tornar isso mais rigoroso, exigindo um número definido de agentes para relatar a falha ou concordância total entre eles, para um endpoint em que um alerta falso é pior do que um lento.
Após a confirmação, o alerta segue o atraso que cada contato escolheu - imediatamente, ou após 3, 5, 15, 30 ou 60 minutos, ou 3, 6, 12 ou 24 horas de falha contínua - pelos nove canais de notificação: e-mail, SMS, chamada de voz, webhook, Slack e os aplicativos de mensagens Telegram, Discord, Viber, Facebook Messenger e Google Chat. O canal de webhook é como os alertas chegam a uma ferramenta de gerenciamento de incidentes ou de chat de equipe.
A verificação é uma requisição HTTP configurável mais análise de resposta, então o que ela atende decorre diretamente disso.
data - e vale a pena confirmar que o membro errors está ausente, já que o
GraphQL é conhecido por responder 200 com erros dentro.O que não se encaixa é uma sequência - obter um token, usá-lo, depois excluir o recurso. Um monitor de API faz uma requisição por execução. Para uma jornada genuína de várias etapas, a verificação de transação conduzida por navegador é a ferramenta certa; para o tempo de carregamento de uma página em vez de um endpoint, veja tempo de acesso ao navegador e carregamento de página.
Essas coisas são complementares e frequentemente confundidas. Uma plataforma de observabilidade ou APM instrumenta seu código e diz o que aconteceu dentro de uma requisição. O monitoramento externo de API fica fora da sua infraestrutura e diz o que um consumidor realmente recebe. Vale a pena ter ambos; nenhum substitui o outro.
| Monitoramento externo de API | APM / observabilidade | |
|---|---|---|
| Ponto de vista | Fora da sua infraestrutura, pela internet pública | Dentro do processo da sua aplicação |
| Exige mudanças no código | Não - nada é instalado em lugar nenhum | Um agente ou SDK em cada serviço |
| Vê problemas de DNS, roteamento, TLS e CDN | Sim - eles estão no caminho que ela percorre | Não - eles acontecem antes de a requisição chegar |
| Continua reportando quando toda a plataforma está fora do ar | Sim - ela não é hospedada por você | Frequentemente não - o que reporta também está fora do ar |
| Explica por que uma requisição foi lenta dentro do seu código | Não - ela vê a divisão de tempos, não a sua stack | Sim - esse é todo o seu propósito |
| Cobre um endpoint que ninguém chamou hoje | Sim - ela o chama em um cronograma | Não - sem tráfego, sem telemetria |
O padrão em que a maioria das equipes acaba é monitoramento externo para detecção e telemetria interna para diagnóstico: a HostTracker diz que um endpoint quebrou, de onde e contra qual regra, e o seu próprio tracing diz por quê. Junto com isso, um monitor de consultas de banco de dados muitas vezes explica uma API que ficou lenta, e o monitoramento de carga de servidor explica o host em que ela roda.
Uma ferramenta de monitoramento de API envia requisições aos seus endpoints em um cronograma definido e avalia a resposta de acordo com regras que você configura, em vez de apenas confirmar que o servidor respondeu de alguma forma. O monitoramento de API da HostTracker primeiro verifica se o endpoint está acessível e retorna o código de status HTTP esperado, depois checa se o tipo de conteúdo da resposta corresponde ao esperado (JSON, XML, texto simples, entre outros) e, por fim, procura no corpo da resposta por valores ou padrões específicos que você configurou. Essa abordagem em camadas identifica problemas que uma simples verificação de "está no ar" jamais detectaria - um endpoint pode retornar um código de status 200 normal e, ainda assim, entregar dados corrompidos, incompletos ou desatualizados por causa de um bug no backend, uma consulta ao banco de dados que falhou ou uma integração quebrada mais adiante na cadeia. Definir políticas de validação claras desde o início garante que o monitor saiba exatamente como deve ser uma resposta saudável para a sua API específica.
O monitoramento de uptime de sites normalmente verifica se uma página carrega e retorna um código de status HTTP normal, o que funciona bem para páginas destinadas à visualização em um navegador. O monitoramento de API vai além, porque as APIs são consumidas por código, não por pessoas, então uma resposta "funcionando" precisa atender a requisitos mais rígidos: o tipo de conteúdo correto, estrutura válida e valores corretos dentro do payload, e não apenas um código de status de sucesso. Um endpoint pode retornar HTTP 200 enquanto os dados reais estão errados, ausentes ou malformados, e as verificações tradicionais de uptime, sozinhas, não detectam isso, pois olham apenas para o código de resposta. O monitoramento de API da HostTracker verifica ambas as camadas - acessibilidade e código de status, como faz o monitoramento de uptime, além da validação do tipo de conteúdo e da busca no corpo da resposta por valores esperados - oferecendo um panorama muito mais preciso sobre se uma API está realmente funcionando corretamente.
Sim, esse é o cerne do que diferencia o monitoramento de API de uma simples verificação de uptime. A HostTracker permite definir políticas de validação que vão além de confirmar que o endpoint respondeu: você pode especificar o tipo de conteúdo esperado, para que a verificação falhe se um endpoint começar a retornar HTML em vez de JSON inesperadamente (um sintoma comum de uma página de erro sendo servida no lugar dos dados reais), e pode buscar no conteúdo da resposta por valores específicos que precisam estar presentes para que a resposta seja considerada saudável. Isso significa que uma verificação pode falhar mesmo quando o código de status HTTP parece perfeitamente normal, identificando casos em que um bug no backend ou uma integração quebrada mais adiante produz uma resposta tecnicamente bem-sucedida, mas funcionalmente incorreta. Validar o conteúdo real, e não apenas a conectividade, é o que torna o monitoramento de API relevante para endpoints dos quais outros sistemas dependem.
Depois de confirmar que o endpoint responde e que o tipo de conteúdo corresponde ao esperado, o monitoramento de API da HostTracker procura no conteúdo retornado pelos valores ou padrões de texto específicos que você configurou como parte da política de validação da verificação. Isso permite confirmar que uma resposta contém um campo específico, um valor de status ou um dado que indica que o endpoint está funcionando corretamente - por exemplo, verificar se a resposta de um endpoint de health-check inclui o valor de status esperado, em vez de uma mensagem de erro embutida em uma resposta 200. Se o conteúdo esperado não for encontrado, a verificação é marcada como falha, mesmo que a conexão em si tenha sido bem-sucedida, e você é alertado através dos canais de notificação configurados. Esse tipo de verificação sensível ao conteúdo é especialmente útil para detectar falhas parciais, quando uma API está tecnicamente acessível, mas silenciosamente retornando dados incompletos ou incorretos.
A frequência das verificações é configurável, e os planos pagos da HostTracker suportam intervalos de até um minuto em todos os tipos de monitoramento, permitindo que endpoints de API críticos para o uptime da sua aplicação sejam verificados quase continuamente. O plano gratuito permanente executa verificações a cada 30 minutos em até dois monitores, o que é uma frequência razoável para APIs de menor prioridade ou internas, nas quais um pequeno atraso na detecção de um problema não gera grandes custos. Para APIs essenciais para o negócio - aquelas que sustentam uma aplicação em produção, um fluxo de pagamento ou uma integração da qual seus clientes dependem - intervalos mais curtos significam que os problemas são detectados e resolvidos antes de se transformarem em uma interrupção maior que os usuários realmente percebam. Um teste gratuito de 30 dias com todos os recursos, verificações de 1 minuto e sem necessidade de cartão de crédito permite testar qual é a velocidade de detecção ideal para a sua API.
Sim. Um monitor de API pode enviar o que quer que o endpoint exija para aceitar a requisição: cabeçalhos personalizados arbitrários - é assim que se fornece um token bearer, um cabeçalho de chave de API ou um identificador de tenant - além de um usuário e senha para autenticação HTTP, um corpo de requisição para POST, PUT ou PATCH, e qualquer método HTTP, de GET e HEAD a POST, PUT, PATCH e DELETE. O conselho prático é o mesmo de qualquer cliente automatizado: emita para o monitor sua própria credencial em vez de reutilizar a de uma pessoa, dê a ela o escopo mais restrito que ainda exercite o endpoint de forma significativa, e prefira um endpoint somente leitura ou uma rota de health dedicada em vez de qualquer coisa que altere dados. Se seus tokens têm vida curta, aponte o monitor para um endpoint cuja autenticação não expira - uma rota de health ou status protegida por uma chave de longa duração - em vez de tentar fazer o monitor realizar uma troca de token que ele não tem como fazer.
As verificações de API são executadas em um intervalo de um minuto até 24 horas - 1, 2, 3, 5, 10, 15, 30 e 45 minutos, depois 1, 2, 4, 6, 12 e 24 horas - e um novo monitor usa três minutos por padrão. Elas são executadas a partir da frota pública de checkpoints da HostTracker, que abrange mais de 300 checkpoints em 158 cidades, e você escolhe quais locais um determinado monitor usa. Executar a partir de várias regiões importa mais para uma API do que para um site: um endpoint atrás de uma CDN ou de um balanceador de carga geodistribuído pode estar perfeitamente saudável em uma região e falhando em outra, e uma verificação de local único simplesmente não consegue ver isso. Isso também impulsiona o controle de alarmes falsos - quando um checkpoint relata uma falha, a verificação é repetida a partir de outros checkpoints independentes, e a mudança de estado só é confirmada quando o quórum concorda, então uma única rota de rede instável entre um data center e o seu host não aciona ninguém.
Os dois. Para um teste pontual, a verificação HTTP gratuita executa seu endpoint a partir de mais de 300 locais agora mesmo, sem necessidade de conta. Um monitor de API é a mesma requisição repetida em um cronograma, com a frequência de até uma vez por minuto, com suas regras de validação aplicadas a cada resposta e um alerta no momento em que uma delas falha. A maioria das equipes começa pelo verificador para ver o que um local reporta, e depois adiciona o monitor para os endpoints dos quais seus clientes ou integrações dependem.
Quando uma verificação de monitoramento de API falha - seja porque o endpoint não respondeu, retornou um tipo de conteúdo inesperado ou não continha os valores exigidos pela sua política de validação - a HostTracker envia um alerta através de qualquer um dos 9 canais de notificação que você configurou, incluindo e-mail, SMS, chamada de voz, webhook, Slack e os aplicativos de mensagens Telegram, Discord e Viber. Isso permite que sua equipe descubra uma API quebrada ou degradada no momento em que o problema é detectado, em vez de por meio de um chamado de suporte depois que a integração já vinha falhando silenciosamente por horas. Como a verificação avalia tanto a acessibilidade quanto o conteúdo, o alerta reflete um problema funcional real na API, e não apenas uma instabilidade de conectividade, o que ajuda a evitar tanto incidentes não detectados quanto ruído desnecessário.
Inicie um teste gratuito e seja alertado no momento em que um endpoint retornar o status errado, quebrar seu contrato ou ficar mais lento.
Faz parte do software de monitoramento de sites da HostTracker.