Saltar al contenido principal

Monitoreo de carga de servidores

Software de monitorización de servidores: comprobaciones de CPU, RAM, disco y SNMP

La monitorización de servidores de HostTracker lee la carga de CPU, RAM y disco de tu servidor Linux o Windows mediante un pequeño endpoint colector o SNMP, representa la tendencia y te avisa en cuanto se supera un umbral que hayas definido, antes de que el servidor caiga.

  • Confianza desde 2004
  • 500.000+ sitios web monitorizados
  • 300+ puntos de control en todo el mundo

Cómo se ejecuta una comprobación de carga del servidor, desde el colector hasta la alerta

Sin agente en su servidorSu servidor expone un único endpoint de solo lectura que devuelve un número. HostTracker lo consulta según su horario.
CPU, RAM, disco y másCarga, memoria, espacio en disco, el tiempo de conexión de un puerto, el tiempo de respuesta de una base de datos o cualquier contador de rendimiento de Windows.
Dos umbrales, una alertaUn nivel de advertencia y un nivel crítico, comprobados cada 1 minuto a 24 horas, con un margen anti-rebote para que un pico aislado no avise a nadie.

Tres formas de exponer el número

Elija una; nada se envía a su máquina.

Opción 1

El recolector PHP

Un script listo para usar para un host Linux o Unix que ya ejecuta PHP. Colócalo en un directorio servido por web y apunta el monitor a esa URL base. Lee localmente las propias cifras de CPU, memoria y disco de la máquina y responde con el número.

Opción 2

El recolector ASP.NET

El equivalente en Windows, para un host que ejecuta IIS. Misma idea, además de acceso a cualquier contador de rendimiento de Windows por categoría, nombre e instancia - así que cualquier cosa que el Monitor de rendimiento pueda mostrarte localmente puede monitorearse de forma remota.

Opción 3

Tu propio endpoint

Apunta el monitor a cualquier URL que quieras y responde con un pequeño objeto JSON. Diez líneas en cualquier lenguaje, nada en tu servidor que tú no hayas escrito, y decides exactamente qué números se exponen. Esta es la opción que terminan prefiriendo la mayoría de los equipos de ingeniería.

Monitoreo de Servidores

Espacio en disco, CPU y memoria: detecta problemas de recursos antes de que causen caídas

CPU

Seguimiento de la Carga de CPU

HostTracker monitorea el uso de CPU para mantener los servidores eficientes y estables. Rastrea el uso de CPU de tu servidor, identificando problemas y alertándote sobre picos inusuales. Monitorear la carga de CPU ayuda a los administradores a mantener sus servidores funcionando sin problemas y a prevenir caídas.

Memoria

Tendencias de Uso de Memoria

HostTracker monitorea el uso de memoria para ayudar a mantener el rendimiento del servidor. Esta función rastrea el uso de memoria e identifica tendencias que podrían causar lentitud o bloqueos. Los informes y alertas ayudan a los administradores a mejorar el uso de la memoria. Un buen monitoreo de RAM significa que las aplicaciones funcionan bien y no hay sorpresas por problemas de memoria.

Disco

Alertas de Espacio en Disco

El monitoreo de HDD de HostTracker previene problemas de almacenamiento que afectan el rendimiento del servidor. Este servicio rastrea el uso del espacio en disco y alerta a los administradores para prevenir problemas como falta de almacenamiento o fallos del disco. El monitoreo y los informes te ayudan a mantener el control del espacio en disco, para que tu servidor siempre tenga suficiente espacio para funcionar sin problemas. Esto ayuda a mantener los servidores confiables y a prevenir la pérdida de datos por problemas de almacenamiento.

Qué registra un monitor de servidor

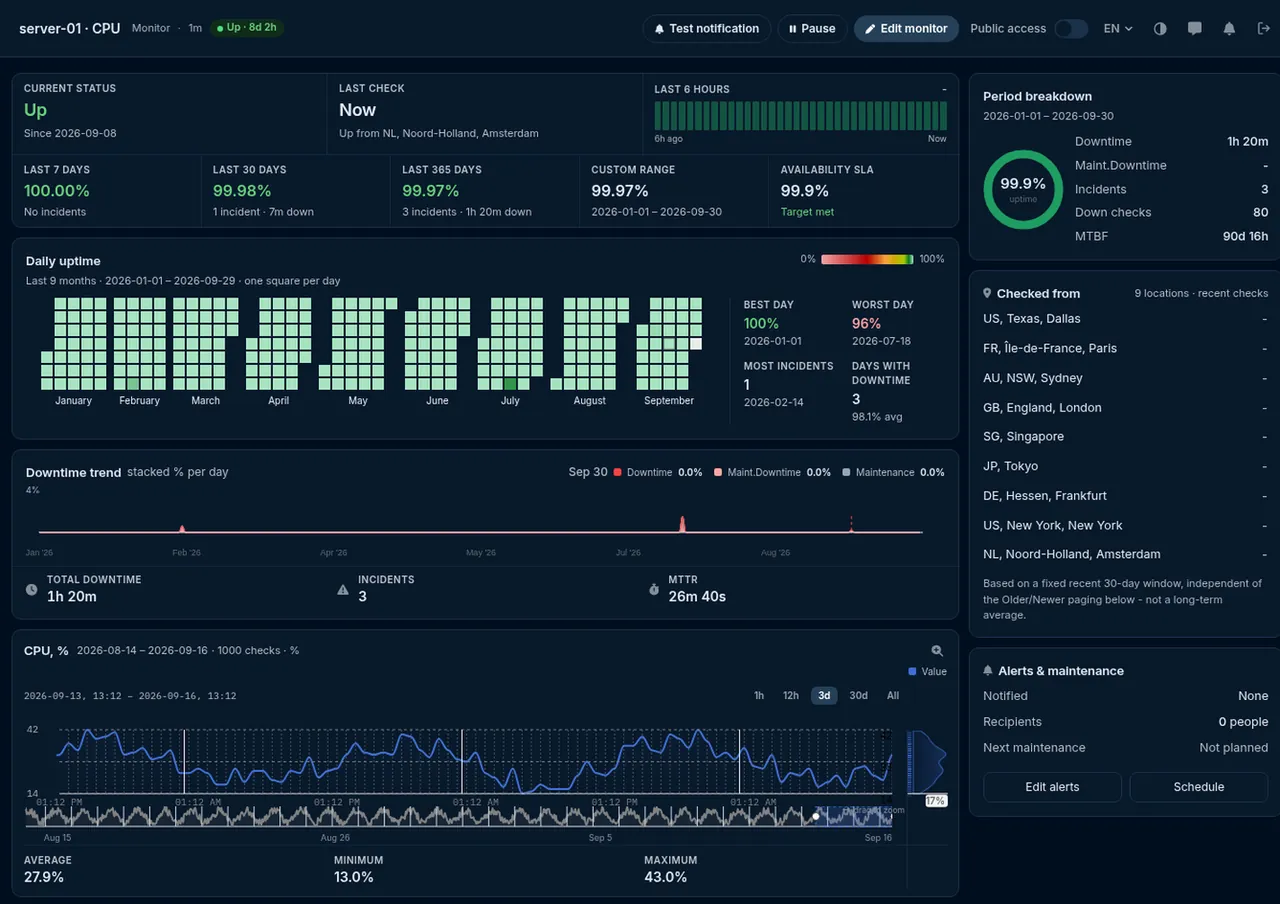
El valor por comprobación frente a ambos umbrales, para que la tendencia sea visible mucho antes de la alerta.

El gráfico del valor

CPU, RAM o disco a lo largo del tiempo con las líneas de advertencia y crítica dibujadas - un disco que se llena es una pendiente, no una sorpresa.

Alertas según el nivel elegido

Advertencia y crítico llegan cada uno a sus propios contactos, tras el número de comprobaciones fallidas que usted defina.

Estadísticas del monitor de carga del servidor de HostTracker: el valor del contador a lo largo del tiempo frente a sus umbrales

Cada capa de su infraestructura, monitoreada

Sitios web, servidores, APIs, certificados. Un tipo de comprobación por página, con las mismas ubicaciones, alertas e informes detrás.

"Llevo mucho tiempo trabajando con este servicio de monitorización, y mi rutina diaria ya no es un problema. Vigila silenciosamente todos mis sitios y me permite reaccionar en cuanto algo falla."
Caleb Levy - Webmaster - CA - Trustpilot

Con la confianza de equipos en

Microsoft Panasonic OTP Bank OneProvider Worldmate
La guía completa

Monitorización de servidores, explicada

Cada capítulo se abre en su sitio, así la página se mantiene corta.

Cómo llegan los números a HostTracker - sin agente en tu servidor

La mayoría de los productos de monitoreo de servidores te piden instalar un agente: un proceso en segundo plano con acceso a nivel de sistema que se ejecuta permanentemente en tu máquina y transmite datos hacia afuera. HostTracker deliberadamente no lo hace. Es un servicio de monitoreo externo, y una verificación de carga de servidor funciona al revés - tu servidor expone un pequeño endpoint de solo lectura que reporta un único número, y HostTracker lo consulta según el horario que definas.

Esa inversión es todo el diseño. No hay un daemon que mantener con vida, ningún software con privilegios que tú no escribiste ejecutándose en producción, ninguna credencial entregada a un tercero, y ningún puerto de administración entrante. Lo que expones es una URL que no acepta comandos, no cambia nada y devuelve un único valor.

Nunca se envía nada a tu máquina. El recolector lo despliegas tú, cuando eliges hacerlo, y HostTracker solo le hace una solicitud. Si lo eliminas, el monitoreo se detiene - no tiene ninguna otra forma de entrar.

Monitorización de salud del servidor: qué puede medir un monitor de servidor

Cada monitor vigila un solo valor, así que un servidor típico termina con tres o cuatro de ellos - y cada uno tiene su propio umbral, su propio historial y su propia alerta. Los tipos de valor son:

MétricaSe reporta comoPara qué sirve
CPUPorcentaje de utilizaciónSaturación sostenida, procesos descontrolados, instancias subdimensionadas, la carga que añadió una implementación
RAMPorcentaje de utilizaciónFugas de memoria, consumo creciente entre reinicios, la presión que precede a un cierre por falta de memoria
DiscoPorcentaje de utilización de una ruta o unidad que nombrasRegistros, subidas y copias de seguridad llenando un volumen - la caída más lenta y predecible que existe
Puerto TCPTiempo de conexión en milisegundosSi un servicio de la máquina sigue aceptando conexiones, y con qué rapidez
SQL ServerTiempo de conexión en milisegundosAccesibilidad y autenticación de la base de datos desde el propio punto de vista del servidor
MySQLTiempo de conexión en milisegundosLo mismo, para MySQL
Contador de rendimiento de WindowsLo que sea que reporte el contadorCualquier cosa que exponga el Monitor de rendimiento, por categoría, nombre de contador e instancia - longitudes de cola, handles, cifras por proceso

Si lo que necesitas es la base de datos detrás del servidor en lugar de su tiempo de conexión, eso es una verificación distinta y más profunda: un monitor de consultas de base de datos se conecta, se autentica, ejecuta una consulta que tú escribes y compara el valor que devuelve contra un umbral.

Escribir tu propio recolector

El contrato es deliberadamente trivial, porque la idea es que puedas leerlo de una sentada e implementarlo en el lenguaje que ya usa tu equipo. HostTracker solicita tu URL; tu endpoint responde con un objeto JSON que contiene el valor:

{ "v": 42.7 }

Esa es toda la superficie requerida. Dos miembros opcionales hacen el resultado más útil: e lleva una cadena de error cuando el valor no pudo leerse esa vez - un resultado mucho mejor que reportar un cero engañoso -, y vs lleva una cadena de versión propia, que aparece en el resultado para que puedas saber qué versión del recolector respondió.

{ "v": 91.4, "e": "", "vs": "collector-2.1" }

Como tú escribes el lector, no estás limitado a lo que un agente genérico sabe recolectar. Profundidad de cola, tasa de aciertos de caché, cantidad de trabajos en espera, antigüedad del registro sin procesar más antiguo, inodos libres, el tamaño de un directorio que nunca debe crecer - cualquier cosa que puedas expresar como un número se convierte en un valor monitoreado con umbrales, historial y alertas propios.

Protege el endpoint. Tiene que ser accesible para los verificadores que lo consultan, así que trátalo como cualquier otra URL pública: colócalo en una ruta imposible de adivinar, mantenlo de solo lectura, y expón solo los números con los que te sientas cómodo. No acepta parámetros que cambien nada, lo que limita la exposición a exactamente un valor.

Configurar un umbral que signifique algo

Un número crudo es un dato; un umbral es lo que lo convierte en monitoreo. Cada monitor lleva una condición y uno o dos límites, así que puedes expresar la forma de "incorrecto" en lugar de solo un techo:

  • mayor que o menor que un límite - la forma habitual. CPU por encima de 90. Disco libre por debajo de 10.
  • igual a o distinto de un límite - para un valor que en realidad es un estado: un número de workers que debe mantenerse en 4, un flag que debe mantenerse en 0.
  • dentro de un rango o fuera de un rango, con dos límites - la forma correcta para cualquier cosa con una franja saludable en lugar de un máximo saludable. Una cola que normalmente está entre 10 y 500 te está diciendo algo cuando marca 0, y otra cosa cuando marca 5.000.
  • sin condición alguna - recolecta y grafica el valor sin que la verificación falle nunca. Útil para una métrica sobre la que quieres historial antes de saber cómo se ve "malo".

El debounce es el ajuste que detiene el ruido

Junto al umbral hay un conteo de verificaciones sobrecargadas consecutivas antes de que el monitor se declare caído, ajustable desde cero hasta veinte. Es el ajuste más valioso de la página y el que más a menudo se deja sin tocar. Un servidor al 95% de CPU durante una sola muestra durante una copia de seguridad nocturna no es un incidente. Un servidor al 95% durante cinco verificaciones seguidas sí lo es. Ajusta el conteo para que coincida con cuánto tiempo tu carga de trabajo tiene permitido legítimamente estar ocupada, y toda una categoría de falsas alarmas de las 3 de la madrugada desaparece sin que tu umbral se vuelva menos estricto en absoluto.

Esto importa más aquí que en una verificación web, porque una métrica de servidor se lee de una única fuente autorizada - tu propio recolector - en lugar de confirmarse en varios puntos de verificación independientes, como sí lo hace una verificación de disponibilidad. No hay una segunda opinión que promedie un pico momentáneo, así que el conteo de debounce es lo que cumple ese papel.

De qué te avisa cada métrica

Las tres métricas principales fallan de formas genuinamente distintas, y saber cuál estás mirando te dice cuánto tiempo tienes.

MétricaCómo llega el falloCuánto aviso obtienes
CPUNada se rompe. Todo se vuelve más lento - cada solicitud, cada consulta, cada trabajo en segundo plano - y el sitio se degrada mucho antes de caer del todo.Normalmente mucho, si estás vigilando. Un ascenso sostenido es visible durante horas o días antes de volverse visible para el usuario.
RAMRepentino y violento. El sistema operativo mata las aplicaciones para recuperar memoria, se reinician, y vuelven a morir - produciendo exactamente la caída intermitente e irreproducible más difícil de diagnosticar.Poco, al final. Pero el ascenso lento de una fuga de memoria entre reinicios es una de las señales más legibles en el monitoreo, si existe el historial.
DiscoTodo a la vez. Los registros dejan de escribirse, la base de datos rechaza escrituras, las sesiones fallan, no se pueden crear archivos temporales - y la causa es invisible en los propios mensajes de error de la aplicación.El mayor aviso de todos, y el que más se pasa por alto. Un volumen que se llena a un ritmo constante es predecible con días de anticipación.
Tiempo de conexiónUna dependencia de la que depende el servidor se volvió lenta o inaccesible, antes de que eso haya salido a la superficie como una caída total.A menudo la señal más temprana que obtienes de que algo aguas abajo está mal.

El disco merece su reputación como la caída clásica y evitable. Es el único fallo que un monitor con un umbral y una semana de historial siempre atrapará primero, y el más vergonzoso de explicar después.

Lee la tendencia, no solo la alerta

Cada lectura se almacena, así que cada monitor de servidor tiene su propio gráfico del valor a lo largo del tiempo, con el promedio, el mínimo y el máximo de la ventana que estés mirando. Los porcentajes se grafican como porcentajes y los tiempos de conexión en milisegundos, así que un monitor de CPU y un monitor de latencia de base de datos se leen cada uno como esperas.

La alerta te dice que algo cruzó una línea; el gráfico te dice las dos cosas que realmente necesitas a continuación. ¿Esto es nuevo? - un pico que parece alarmante en aislamiento suele ser el mismo pico que ha ocurrido cada martes a las 02:00 durante un año. Y ¿hacia dónde va? - una cifra de memoria que sube de forma constante entre reinicios es una fuga, sea cual sea su valor actual, y un disco que sube dos por ciento a la semana tiene una fecha asociada.

Esa segunda pregunta es el uso de planificación de capacidad del monitoreo de servidores, y es la razón para empezar a recolectar una métrica antes de saber qué umbral ponerle. Puedes añadir el umbral en un mes, una vez que el historial te haya dicho cómo se ve lo normal. El historial que no recolectaste es el que no puedes recuperar.

El monitoreo de servidores y el monitoreo de uptime responden preguntas distintas

Son complementos, no alternativas, y la división es lo bastante clara como para decirla sin rodeos.

Monitoreo de uptimeMonitoreo de servidores
La pregunta que responde¿Puede un visitante llegar al sitio ahora mismo?¿Está la máquina de abajo lo bastante saludable para seguir respondiendo?
Desde dónde miraDesde fuera - más de 300 puntos de verificación en 158 ciudadesDesde dentro - un valor leído en la propia máquina
Momento típicoTe avisa en el instante del falloTe avisa antes del fallo, si defines el umbral por debajo del precipicio
Control de falsas alarmasUna observación fallida se vuelve a verificar desde otros puntos de verificación y se confirma por quórumUna única lectura autorizada, con un conteo de sobrecargas consecutivas como debounce
Detecta una fuga de memoriaNo - hasta que finalmente rompe algoSí - como tendencia, semanas antes
Detecta un fallo de ruta de red entre tus usuarios y túSíNo - la máquina está perfectamente bien

Ejecutar solo uno de los dos deja un vacío real en cada dirección. La combinación en la que se asientan la mayoría de las cuentas es una verificación de disponibilidad cada minuto desde varias ubicaciones más un puñado de monitores de servidor en CPU, memoria y el volumen con más probabilidades de llenarse.

Monitorización SNMP, para el hardware que nunca ejecutará un recolector

Los routers, switches, firewalls, unidades UPS e impresoras no pueden alojar un script, pero casi todos ya hablan SNMP. Una verificación SNMP separada lee un valor numérico directamente del dispositivo por OID - contadores de interfaz, temperatura, carga, tiempo de actividad, carga de batería - sobre SNMP v1, v2c o v3, incluido v3 con autenticación y privacidad para que las credenciales no viajen en claro.

Para ser sincero sobre dónde está esto hoy: una verificación SNMP lee y registra el valor que reporta el dispositivo. Las alertas basadas en umbral sobre un valor SNMP todavía no están disponibles - cuando necesitas que un número realmente genere un incidente, usa un monitor de carga de servidor contra un recolector, que tiene el modelo completo de condición y debounce descrito arriba.

Configurar el monitoreo de servidores

  1. Decide qué exponer. Si tu servidor ya ejecuta PHP o IIS, el recolector listo para usar correspondiente es el camino más rápido; si no, escribe el endpoint tú mismo - devuelve un número.
  2. Despliégalo en el servidor que quieres vigilar y confirma que puedes solicitarlo tú mismo. Colócalo en una ruta imposible de adivinar. Si la máquina es nueva, la verificación gratuita de puerto TCP y la prueba de ping gratuita son una forma rápida de confirmar que es accesible desde el mundo exterior antes de seguir - sin necesidad de iniciar sesión.
  3. Añade un monitor de tipo Monitorear CPU, RAM, HDD, elige qué valor lee, y dale la URL del recolector. Para un monitor de disco, nombra la ruta o unidad; para un monitor de tiempo de conexión de base de datos, da los datos de conexión que debe marcar el recolector.
  4. Define la condición y los límites - y define el conteo de sobrecargas antes de caer de forma deliberada en lugar de dejarlo en el valor por defecto. Este es el ajuste que decide si el monitor resulta útil o se ignora.
  5. Elige un intervalo, de un minuto a 24 horas. Un minuto es adecuado para una máquina que ejecuta algo crítico para el negocio; 5 o 10 minutos son suficientes para una tendencia como el uso de disco.
  6. Repite para cada valor que importe en ese host - CPU, memoria y el volumen con más probabilidades de llenarse es un buen conjunto inicial - y luego añade los contactos que deben enterarse.
  7. Déjalo correr una semana antes de ajustar nada. La primera semana de historial es lo que te dice si tu umbral es correcto, y es una evidencia mucho mejor que una suposición hecha el primer día.

Límites que conviene conocer

  • El recolector tiene que ser accesible. Un host sin ningún acceso entrante no puede consultarse. Lo que hay que exponer es una URL de solo lectura, no un puerto de administración - pero sí tiene que estar expuesto.
  • Un monitor vigila un solo valor. CPU, memoria y disco son tres monitores, cada uno con su propio umbral y su propio historial. Eso es lo que hace precisas las alertas, y sí significa que un servidor ocupado usa varios cupos de monitor.
  • Los contadores de rendimiento de Windows necesitan el recolector ASP.NET. La terna categoría / nombre / instancia la lee localmente ese recolector; un host PHP reporta CPU, memoria, disco y tiempos de conexión en su lugar.
  • No hay confirmación multiubicación. A diferencia de una verificación de disponibilidad, una métrica de servidor viene de una única fuente autorizada, así que una sola lectura anómala es una lectura real. El conteo de sobrecargas consecutivas es la herramienta para eso, y vale la pena configurarlo.
  • Reporta lo que reporta el recolector. Si tu endpoint personalizado tiene un error, el monitor alerta fielmente sobre el número equivocado - por eso importa el miembro opcional de error en la respuesta: reporta un error en vez de un cero.
  • No hay contador de tráfico de red. Los valores disponibles son CPU, memoria, uso de disco, tiempos de conexión y contadores de rendimiento de Windows; el ancho de banda no está entre ellos. Para un dispositivo que reporta tráfico por SNMP, una verificación SNMP puede leer y graficar ese contador.

Preguntas frecuentes

El monitoreo de servidores es el seguimiento continuo del uso de los recursos principales de tu servidor - carga de CPU, uso de RAM (memoria) y carga del disco (HDD) - para que puedas ver cómo está rindiendo realmente tu infraestructura, no solo si el sitio web que corre sobre ella responde. El monitoreo de servidores de HostTracker revisa estas tres métricas e informa sobre tendencias y picos a lo largo del tiempo, algo importante porque el agotamiento de recursos es una de las causas más comunes detrás del rendimiento lento, los bloqueos y las caídas totales. Un servidor puede estar técnicamente "activo" y aun así estar a punto de fallar si el uso de CPU está al límite, la memoria está casi agotada o el espacio en disco es críticamente bajo - nada de lo cual una simple verificación de disponibilidad revelaría necesariamente hasta que el problema ya haya causado una caída visible.

Un servidor puede seguir siendo accesible y estar técnicamente en línea mientras opera peligrosamente cerca de sus límites de recursos, lo que significa que un uso alto de CPU o RAM suele ser una señal de alerta temprana más que el problema en sí. Una carga de CPU sostenida y alta ralentiza cada solicitud que procesa el servidor, degradando la experiencia de todos los visitantes aunque el sitio nunca llegue a caerse por completo. La presión de memoria es aún más peligrosa - a medida que el uso de RAM se acerca a su capacidad, las aplicaciones pueden empezar a bloquearse, reiniciarse o ser cerradas por el sistema operativo para liberar memoria, lo que suele provocar caídas intermitentes y difíciles de diagnosticar que parecen fallos aleatorios en lugar de un error claro. Detectar un uso elevado de CPU o RAM mediante el monitoreo de servidores, antes de que escale a un bloqueo, le da a los administradores tiempo para investigar y ampliar la capacidad de forma proactiva.

Cuando el monitoreo de CPU, RAM o carga del disco detecta actividad inusual - un pico sostenido, memoria acercándose a su capacidad o espacio en disco agotándose - HostTracker envía una notificación a través de cualquiera de sus 9 canales de alerta configurados, incluyendo email, SMS, llamada de voz, webhooks, Slack y aplicaciones de mensajería como Telegram, Discord y Viber. Esto significa que la persona responsable de la infraestructura del servidor se entera de un problema de recursos en desarrollo directamente, en lugar de descubrirlo solo después de que ya haya causado una lentitud o un bloqueo que los clientes notan. Como los informes y alertas se generan automáticamente a partir de los datos monitoreados, los administradores obtienen un historial documentado de las tendencias de recursos junto con la notificación en tiempo real, lo que ayuda a distinguir un pico puntual de un problema real de capacidad que necesita una solución a más largo plazo.

El monitoreo de uptime responde una pregunta más acotada: si el sitio web o servicio es accesible y responde en este momento. El monitoreo de servidores mira debajo de esa superficie, a la infraestructura que realmente hace funcionar el sitio - carga de CPU, uso de memoria y espacio en disco - que con frecuencia son la causa raíz detrás de una falla de uptime en lugar de un asunto separado y sin relación. Un servidor con poca memoria o espacio en disco todavía puede pasar una verificación de uptime durante un tiempo antes de finalmente bloquearse o volverse extremadamente lento, así que confiar solo en el monitoreo de uptime significa enterarte del problema únicamente después de que ya se convirtió en una caída. Combinar ambos da una imagen más completa: el monitoreo de uptime confirma que el sitio es accesible ahora mismo, mientras que el monitoreo de servidores rastrea las tendencias de recursos subyacentes que predicen si es probable que siga siéndolo.

La frecuencia de verificación es configurable para adaptarse a la rapidez con la que necesitas enterarte de un problema de recursos en desarrollo. Los planes pagos de HostTracker admiten intervalos de monitoreo tan rápidos como una vez por minuto, útil para servidores que ejecutan aplicaciones críticas para el negocio donde un pico de recursos necesita detectarse y resolverse rápidamente. Los servidores menos críticos o de menor tráfico pueden usar un intervalo más largo, y el plan gratuito permanente revisa dos monitores cada 30 minutos, lo cual suele ser suficiente para detectar una tendencia sostenida como el espacio en disco llenándose gradualmente durante varios días, aunque no detectaría un pico de CPU muy breve. Una prueba gratuita de 30 días con todas las funciones y sin tarjeta de crédito te permite probar intervalos de verificación más rápidos y ver cuánto detalle aportan los datos resultantes antes de elegir un plan.

No - no hay ningún agente de HostTracker que instalar, ningún daemon que mantener en ejecución y ninguna credencial que entregar. Una verificación de carga de servidor funciona al revés: tu servidor expone un pequeño endpoint de solo lectura que reporta un único número, y HostTracker lo consulta según el horario que definas. Tienes tres formas de proporcionarlo. Dos son scripts recolectores listos para usar que colocas en un servidor que ya operas - uno para PHP en Linux o Unix, otro para ASP.NET en IIS - y la tercera es escribir el endpoint tú mismo, lo cual toma unas diez líneas en cualquier lenguaje: lee el valor como prefieras y responde con un pequeño objeto JSON que lo contenga. Esa tercera opción es la que prefieren muchos equipos, porque significa que nada que ellos no hayan escrito se ejecuta jamás en su máquina, y deciden exactamente qué números se exponen. Nunca se envía nada automáticamente a tu servidor, y HostTracker nunca abre una sesión de administración en él.

El endpoint recolector tiene que ser accesible para los verificadores de HostTracker, así que un servidor detrás de un firewall sin ningún acceso entrante no puede consultarse directamente. En la práctica esto es un obstáculo menor de lo que parece, porque lo que hay que exponer es una única URL de solo lectura que devuelve un número - no SSH, no un puerto de administración, no un protocolo de monitoreo. Los enfoques habituales son publicar el endpoint en una ruta imposible de adivinar, restringirlo a las direcciones que lo consultan, o alojarlo en una máquina de la misma red que ya está expuesta a internet y hacer que reporte en nombre del host privado. Elijas lo que elijas, la exposición es deliberadamente mínima: el endpoint no acepta comandos, no cambia nada y devuelve un único número. Esa es una conversación de seguridad muy distinta a instalar un agente de terceros con acceso a nivel de sistema, que es exactamente por qué la verificación está diseñada así.

El monitoreo de carga de servidores - verificaciones de CPU, RAM y HDD - es uno de los 13 tipos de verificación disponibles en todo el producto de HostTracker, y el plan gratuito permanente te permite monitorear dos servidores o sitios sin costo, con verificaciones cada 30 minutos. HostTracker en su conjunto no es un producto solo gratuito - es un servicio de monitoreo de pago con un nivel gratuito incluido - así que el plan gratuito funciona bien para probar el monitoreo de servidores en un par de máquinas o como opción ligera para proyectos más pequeños, no como la oferta principal. Para monitorear más servidores, intervalos de verificación más cortos o infraestructura crítica para el negocio donde la detección rápida importa, los planes pagos comienzan alrededor de $5 al mes, y una prueba gratuita de 30 días con todas las funciones y sin tarjeta de crédito te permite probar los intervalos más rápidos antes de decidir.

Prueba gratuita de 30 días - sin tarjeta de crédito

Detecta la sobrecarga del servidor antes de que te derribe

Inicia una prueba gratuita y recibe alertas cuando la carga de CPU, RAM o disco cruce tus umbrales.

Prueba gratuita de 30 días - 100 monitores - sin tarjeta de crédito
  • Confianza desde 2004
  • 500.000+ sitios web monitorizados
  • 300+ puntos de control en todo el mundo

Forma parte del software de monitorización web de HostTracker.