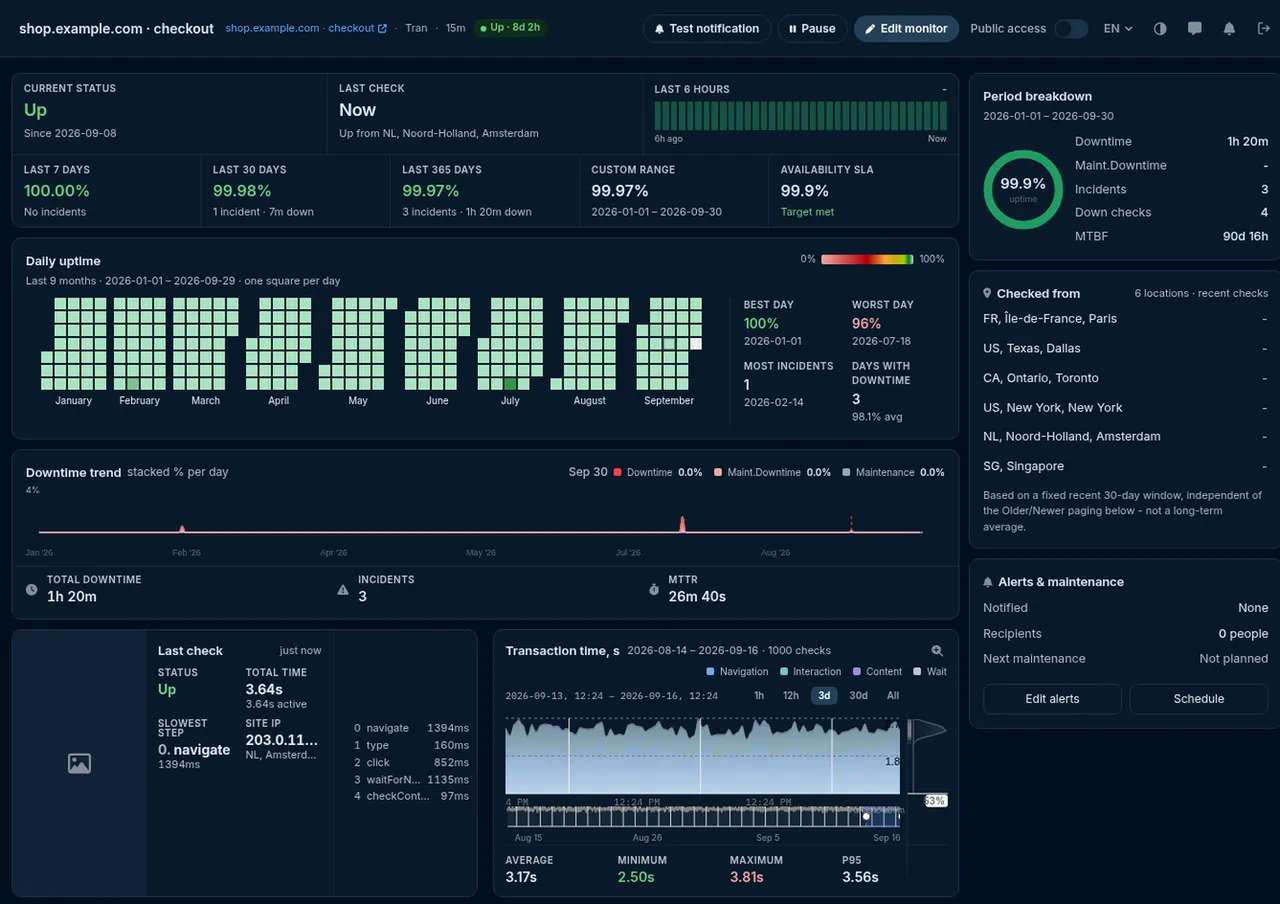
Uruchomienie zatrzymuje się na kroku, który zawiódł, i zapisuje to, co zaobserwowało. Wynik podaje
nazwę kroku, klasyfikuje awarię - przekroczenie limitu czasu, element, którego selektor nie mógł
znaleźć, asercja treści, która się nie zgodziła, błąd HTTP, błąd połączenia, błąd w konsoli
przeglądarki lub błędnie skonfigurowany krok - i zachowuje czasy trwania poszczególnych kroków, adres
URL, IP i kod statusu HTTP, na którym zakończyła się każda nawigacja, komunikaty z konsoli
przeglądarki oraz zrzut ekranu strony w momencie awarii.
Następnie, zanim ktokolwiek zostanie obudzony, wynik jest podwójnie sprawdzany.
Pojedyncza nieudana obserwacja nie jest traktowana jako awaria: test jest ponownie uruchamiany na
dodatkowych, niezależnych checkpointach, a zmiana stanu jest potwierdzana dopiero wtedy, gdy zgadza
się kworum. Domyślnie jest to werdykt większościowy wśród maksymalnie siedmiu agentów, przy minimum
trzech - dzięki czemu jeden niestabilny checkpoint albo jedna przejściowa usterka sieciowa między
centrum danych a Twoim hostem nie mogą samodzielnie wywołać powiadomienia.
Po potwierdzeniu zmiany stanu powiadomienia są wysyłane zgodnie z opóźnieniem wybranym przez każdy
kontakt: natychmiast albo dopiero po 3, 5, 15, 30 lub 60 minutach, albo po 3, 6, 12 lub 24 godzinach
nieprzerwanej awarii. Powiadomienia są wysyłane przez dziewięć kanałów obsługiwanych przez HostTracker
- e-mail, SMS, połączenie głosowe, webhook, Slack, powiadomienie push w przeglądarce oraz komunikatory
Telegram, Discord i Viber - a gdy przepływ znów zaczyna kończyć się powodzeniem, wysyłane jest
powiadomienie o przywróceniu działania.