PHP kolektor
Hotový skript pro Linux nebo Unix host, na kterém už běží PHP. Vložte ho do adresáře obsluhovaného webem a monitor namiřte na tuto základní URL. Lokálně přečte vlastní čísla CPU, paměti a disku stroje a odpoví hodnotou.
Monitoring zátěže serveru
Monitoring serveru od HostTracker čte zátěž CPU, RAM a disku z vašeho serveru Linux nebo Windows přes malý kolektor nebo SNMP, zobrazuje trend v grafu a upozorní vás, jakmile je překročen vámi nastavený práh, dřív, než se server zhroutí.
Jak probíhá jeden test zátěže serveru, od sběrače po alert
Vyberte jeden; na váš stroj se nic neodesílá.
Hotový skript pro Linux nebo Unix host, na kterém už běží PHP. Vložte ho do adresáře obsluhovaného webem a monitor namiřte na tuto základní URL. Lokálně přečte vlastní čísla CPU, paměti a disku stroje a odpoví hodnotou.
Windows ekvivalent, pro host s IIS. Stejná myšlenka, navíc s přístupem k libovolnému výkonnostnímu čítači Windows podle kategorie, jména a instance - takže cokoli vám lokálně ukáže Performance Monitor, lze sledovat vzdáleně.
Namiřte monitor na libovolnou URL a odpovězte drobným JSON objektem. Deset řádků v jakémkoli jazyce, na vašem serveru nic, co jste sami nenapsali, a přesně vy rozhodujete, jaká čísla jsou vystavená. Tuto možnost nakonec preferuje většina vývojářských týmů.
HostTracker sleduje vytížení CPU, aby servery zůstaly efektivní a stabilní. Sleduje vytížení procesoru vašeho serveru, odhaluje problémy a upozorňuje vás na neobvyklé výkyvy. Monitoring zátěže CPU pomáhá administrátorům udržet servery v hladkém chodu a předcházet výpadkům.
HostTracker sleduje využití paměti, aby pomohl udržet výkon serveru. Tato funkce sleduje využití paměti a odhaluje trendy, které by mohly způsobit zpomalení nebo pády. Reporty a upozornění pomáhají administrátorům zlepšit využití paměti. Dobrý monitoring RAM znamená, že aplikace fungují dobře a nedochází k překvapením kvůli problémům s pamětí.
Monitoring HDD od HostTracker předchází problémům s úložištěm, které ovlivňují výkon serveru. Tato služba sleduje využití místa na disku a upozorňuje administrátory, aby předešli problémům, jako je nedostatek úložiště nebo selhání disku. Monitoring a reporty vám pomáhají mít přehled o místě na disku, takže váš server má vždy dost prostoru pro plynulý chod. To pomáhá udržet servery spolehlivé a předchází ztrátě dat kvůli problémům s úložištěm.
Hodnota u každého testu vůči oběma prahům, takže trend je vidět dlouho před alertem.
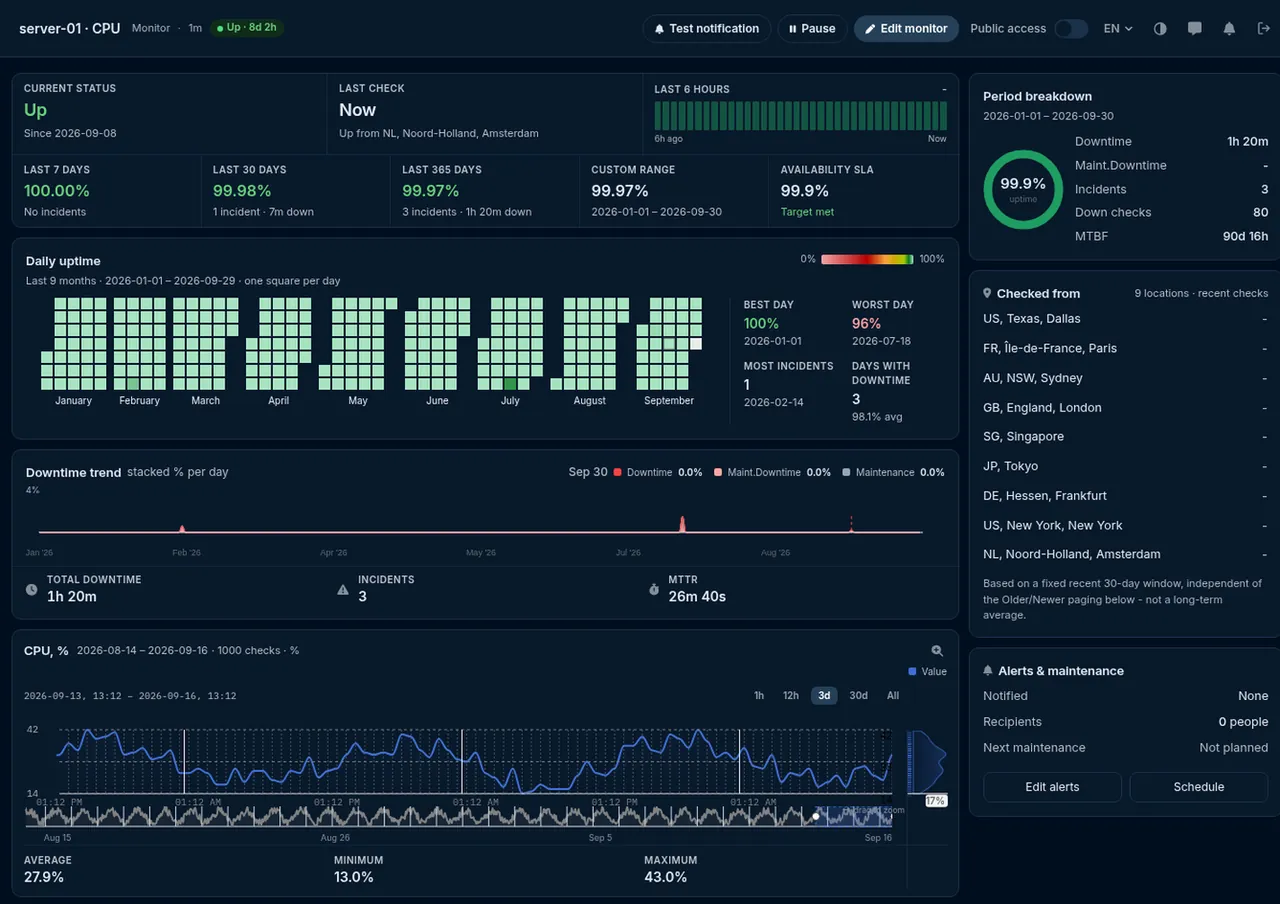
CPU, RAM nebo disk v čase s vykreslenými čarami varovné a kritické úrovně - zaplňující se disk je sklon, ne překvapení.
Varovná a kritická úroveň mají vlastní kontakty, po dosažení počtu neúspěšných testů, který nastavíte.
Weby, servery, API, certifikáty. Jeden typ kontroly na stránku, za všemi stejné lokality, upozornění a reporty.
"S touto monitorovací službou pracuji už dlouho a moje každodenní rutina už není problém. Tiše hlídá všechny moje weby a umožňuje mi zareagovat ve chvíli, kdy se něco pokazí."
Důvěřují nám týmy z
Každá kapitola se otevře na místě, takže stránka zůstává krátká.
Většina produktů pro monitoring serverů po vás chce nainstalovat agenta: proces na pozadí s přístupem na úrovni systému, který běží na vašem stroji trvale a odesílá data ven. HostTracker to záměrně nedělá. Jde o externí monitorovací službu a kontrola zátěže serveru funguje opačně - váš server vystaví jeden malý endpoint jen pro čtení, který hlásí jedno číslo, a HostTracker si ho vyžádá v intervalu, který nastavíte.
Toto obrácení je celý návrh. Nemusíte udržovat v chodu žádného démona, na produkci vám neběží žádný privilegovaný software, který jste sami nenapsali, žádné přihlašovací údaje nikomu nepředáváte a žádný příchozí správní port neexistuje. Vystavujete URL, která nepřijímá žádné příkazy, nic neměnící a vrací jednu hodnotu.
Na váš stroj se nikdy nic nepushuje. Kolektor nasazujete vy, kdy sami chcete, a HostTracker na něj jen posílá požadavky. Pokud ho odstraníte, monitoring se zastaví - jinou cestu dovnitř nemá.
Každý monitor sleduje jednu hodnotu, takže typický server nakonec má tři nebo čtyři z nich - a každá má vlastní práh, vlastní historii a vlastní upozornění. Typy hodnot jsou:
| Metrika | Hlásí se jako | K čemu je dobrá |
|---|---|---|
| CPU | Procento vytížení | Trvalé nasycení, ujeté procesy, poddimenzované instance, zátěž přidaná nasazením |
| RAM | Procento vytížení | Únik paměti, plíživá spotřeba mezi restarty, tlak, který předchází ukončení kvůli nedostatku paměti |
| Disk | Procento vytížení pro vámi pojmenovanou cestu nebo jednotku | Logy, uploady a zálohy zaplňující svazek - nejpomalejší a nejpředvídatelnější výpadek, jaký existuje |
| TCP port | Čas připojení v milisekundách | Zda služba na stroji stále přijímá spojení a jak rychle |
| SQL Server | Čas připojení v milisekundách | Dostupnost databáze a autentizace z pohledu samotného serveru |
| MySQL | Čas připojení v milisekundách | Totéž, pro MySQL |
| Výkonnostní čítač Windows | Cokoli, co čítač hlásí | Cokoli, co vystavuje Performance Monitor, podle kategorie, jména čítače a instance - délky front, handly, čísla po jednotlivých procesech |
Pokud potřebujete spíš databázi za serverem než jeho čas připojení, jde o jinou a hlubší kontrolu: monitor databázových dotazů se připojí, ověří, spustí dotaz, který sami napíšete, a porovná vrácenou hodnotu s prahem.
Kontrakt je záměrně triviální, protože smyslem je, abyste ho přečetli na posezení a implementovali v jakémkoli jazyce, který váš tým už používá. HostTracker si vyžádá vaši URL; váš endpoint odpoví JSON objektem nesoucím hodnotu:
{ "v": 42.7 }
To je celý povinný povrch. Dva volitelné členy dělají výsledek užitečnějším: e nese chybový
řetězec, když se hodnotu tentokrát nepodařilo přečíst - mnohem lepší výsledek než nahlásit zavádějící
nulu - a vs nese vaši vlastní verzi, která se objeví ve výsledku, takže poznáte, který
build kolektoru odpověděl.
{ "v": 91.4, "e": "", "vs": "collector-2.1" }
Protože si čtečku píšete sami, nejste omezeni na to, co umí sbírat obecný agent. Hloubka fronty, poměr zásahů do cache, počet čekajících úloh, stáří nejstaršího nezpracovaného záznamu, volné inody, velikost adresáře, který nikdy nesmí narůst - cokoli, co dokážete vyjádřit číslem, se stane sledovanou hodnotou s prahy, historií a upozorněním.
Endpoint chraňte. Musí být dosažitelný pro kontrolní body, které ho volají, takže s ním zacházejte jako s jakoukoli jinou veřejnou URL: umístěte ho na neuhodnutelnou cestu, udržujte ho jen pro čtení a vystavujte jen čísla, u kterých vám nevadí, že jsou čitelná. Nepřijímá žádné parametry, které by cokoli měnily, takže expozice je omezená přesně na jednu hodnotu.
Syrové číslo jsou data; práh je to, co je promění v monitoring. Každý monitor nese podmínku a jeden nebo dva limity, takže dokážete vyjádřit tvar toho, co je „špatně“, ne jen strop:
Vedle prahu stojí počet po sobě jdoucích přetížených kontrol, než monitor přejde do stavu Down, nastavitelný od nuly do dvaceti. Je to jednotlivě nejcennější přepínač na stránce a zároveň ten nejčastěji ponechaný beze změny. Server na 95 % CPU po dobu jednoho vzorku během noční zálohy není incident. Server na 95 % po pět kontrol za sebou ano. Nastavte počet podle toho, jak dlouho smí být vaše pracovní zátěž legitimně vytížená, a celá kategorie falešných poplachů ve tři ráno zmizí, aniž by váš práh byl o něco méně přísný.
Zde na tom záleží víc než u webové kontroly, protože metrika serveru se čte z jediného autoritativního zdroje - vašeho vlastního kolektoru - místo aby se potvrzovala napříč několika nezávislými kontrolními body, jako je tomu u kontroly dostupnosti. Neexistuje druhý názor, který by zprůměroval chvilkový výkyv, takže tuto roli hraje právě počet debounce.
Tři klíčové metriky selhávají opravdu odlišnými způsoby a vědět, na kterou se díváte, vám řekne, kolik máte času.
| Metrika | Jak selhání přichází | Kolik varování dostanete |
|---|---|---|
| CPU | Nic se nerozbije. Vše se jen zpomaluje - každý požadavek, každý dotaz, každá úloha na pozadí - a web upadá dlouho předtím, než úplně spadne. | Obvykle dost, pokud sledujete. Trvalý nárůst je vidět hodiny nebo dny předtím, než si ho všimnou uživatelé. |
| RAM | Náhlé a prudké. Operační systém aplikace ukončuje, aby uvolnil paměť, ty se restartují a jsou znovu ukončeny - což vytváří přesně ten přerušovaný, těžko reprodukovatelný výpadek, který se nejhůř diagnostikuje. | Málo, na konci. Ale pomalý nárůst úniku paměti mezi restarty je jeden z nejčitelnějších signálů v monitoringu, pokud existuje historie. |
| Disk | Všechno naráz. Logy přestanou zapisovat, databáze odmítá zápisy, relace selhávají, dočasné soubory nelze vytvořit - a příčina je z vlastních chybových zpráv aplikace neviditelná. | Nejvíc varování ze všech, a nejčastěji přehlédnuté. Svazek plnící se konstantní rychlostí je předvídatelný celé dny dopředu. |
| Čas připojení | Závislost, na které server stojí, zpomalila nebo je nedostupná, ještě předtím, než se to projeví jako plný výpadek. | Často nejranější signál, že je něco níže v řetězci špatně. |
Disk si svou pověst klasického předejitelného výpadku zaslouží. Je to jediné selhání, které monitor s prahem a týdnem historie vždy zachytí jako první, a zároveň to, co je nejtrapnější zpětně vysvětlovat.
Každé čtení se ukládá, takže má každý monitor serveru vlastní graf své hodnoty v čase s průměrem, minimem a maximem pro okno, na které se díváte. Procenta se vykreslují jako procenta a časy připojení v milisekundách, takže monitor CPU i monitor latence databáze čtete přesně tak, jak byste čekali.
Upozornění vám řekne, že něco překročilo hranici; graf vám řekne dvě věci, které skutečně potřebujete vědět dál. Je to nové? - výkyv, který vypadá izolovaně alarmující, je často stejný výkyv, který se opakuje každé úterý ve 02:00 celý rok. A kam to směřuje? - hodnota paměti, která mezi restarty plynule roste, je únik, ať je její aktuální hodnota jakákoli, a disk rostoucí o dvě procenta týdně má u sebe přilepené konkrétní datum.
Ta druhá otázka je využití monitoringu serveru pro plánování kapacit, a je to důvod, proč začít sbírat metriku ještě předtím, než víte, jaký na ni nastavit práh. Práh můžete přidat za měsíc, jakmile vám historie řekne, jak vypadá normál. Historie, kterou jste nesbírali, je ta, kterou už nezískáte zpět.
Doplňují se, nejsou alternativou, a rozdělení je dost čisté na to, aby stálo za to ho jasně vyslovit.
| Monitoring dostupnosti | Monitoring serveru | |
|---|---|---|
| Na jakou otázku odpovídá | Dostane se návštěvník na web právě teď? | Je stroj pod ním dostatečně zdravý, aby pořád odpovídal? |
| Odkud se dívá | Zvenčí - z více než 300 kontrolních bodů ve 158 městech | Zevnitř - hodnota přečtená přímo na stroji |
| Typické načasování | Řekne vám to v okamžiku selhání | Řekne vám to předtím, než k selhání dojde, pokud nastavíte práh pod hranu |
| Kontrola falešných poplachů | Selhavší pozorování se znovu ověří z dalších kontrolních bodů a potvrdí kvórem | Jediné autoritativní čtení, s počtem po sobě jdoucích přetížení jako debounce |
| Odhalí únik paměti | Ne - dokud konečně něco nespadne | Ano - jako trend, o týdny dřív |
| Odhalí selhání síťové trasy mezi vašimi uživateli a vámi | Ano | Ne - stroj je naprosto v pořádku |
Provozovat jen jeden z nich zanechává skutečnou mezeru v každém směru. Kombinace, na které se ustálí většina účtů, je jednominutová kontrola dostupnosti z více lokalit plus hrstka monitorů serveru na CPU, paměť a svazek s nejvyšší pravděpodobností zaplnění.
Routery, přepínače, firewally, UPS jednotky a tiskárny nemohou hostit skript, ale téměř všechny už umí SNMP. Samostatná kontrola SNMP přečte číselnou hodnotu přímo ze zařízení podle OID - čítače rozhraní, teplota, zátěž, doba běhu, stav baterie - přes SNMP v1, v2c nebo v3, včetně v3 s autentizací a šifrováním, takže se přihlašovací údaje neposílají otevřeně.
Poctivě k tomu, kde to dnes stojí: kontrola SNMP hodnotu, kterou zařízení hlásí, čte a zaznamenává. Prahové upozorňování na hodnotu SNMP zatím není k dispozici - když potřebujete, aby číslo skutečně vyvolalo incident, použijte monitor zátěže serveru proti kolektoru, který má celý model podmínky a debounce popsaný výše.
Monitoring serveru je průběžné sledování klíčového využití zdrojů vašeho serveru – zátěže CPU, využití RAM (paměti) a zátěže HDD (disku) – abyste viděli, jak vaše infrastruktura skutečně funguje, a ne jen jestli web nad ní odpovídá. Monitoring serveru od HostTracker kontroluje tyto tři metriky a hlásí trendy a výkyvy v čase, což je důležité, protože vyčerpání zdrojů je jednou z nejčastějších hlavních příčin pomalého výkonu, pádů a přímých výpadků. Server může být technicky „dostupný“ a přesto být okamžik od selhání, pokud je vytížení CPU na maximu, paměť je téměř vyčerpaná nebo je kriticky málo místa na disku – nic z toho běžná kontrola dostupnosti nemusí odhalit, dokud problém skutečně nezpůsobí viditelný výpadek.
Server může zůstat dostupný a technicky online, i když běží nebezpečně blízko svých limitů zdrojů, takže vysoké vytížení CPU nebo RAM je často včasným varovným signálem problému spíš než problémem samotným. Trvale vysoká zátěž CPU zpomaluje každý požadavek, který server zpracovává, a zhoršuje zážitek pro každého návštěvníka, i když web nikdy úplně nespadne. Tlak na paměť je ještě nebezpečnější – jak se využití RAM blíží kapacitě, aplikace mohou začít padat, restartovat se nebo je operační systém ukončí, aby uvolnil paměť, což často způsobuje přerušované, těžko diagnostikovatelné výpadky, které vypadají jako náhodné závady spíš než jasné selhání. Zachycení zvýšeného vytížení CPU nebo RAM pomocí monitoringu serveru dřív, než přeroste v pád, dává administrátorům čas problém prošetřit a proaktivně navýšit kapacitu.
Když monitoring zátěže CPU, RAM nebo disku detekuje neobvyklou aktivitu – trvalý výkyv, paměť blížící se kapacitě nebo docházející místo na disku – HostTracker odešle upozornění přes libovolný z 9 alertovacích kanálů, které máte nastavené, včetně e-mailu, SMS, hlasového hovoru, webhooků, Slacku a messengerů jako Telegram, Discord a Viber. To znamená, že osoba zodpovědná za infrastrukturu serveru se o vznikajícím problému se zdroji dozví přímo, místo aby ho objevila až poté, co už způsobil zpomalení nebo pád, kterého si všimnou zákazníci. Protože jsou hlášení a upozornění generovány automaticky z monitorovaných dat, mají administrátoři zdokumentovanou historii trendů zdrojů společně s upozorněním v reálném čase, což pomáhá odlišit jednorázový výkyv od skutečného problému s kapacitou, který vyžaduje dlouhodobější řešení.
Monitoring dostupnosti odpovídá na užší otázku: je web nebo služba právě teď dostupná a odpovídá. Monitoring serveru se dívá pod tento povrch na infrastrukturu, která web skutečně pohání – zátěž CPU, využití paměti a místo na disku – což bývá hlavní příčinou výpadku dostupnosti, a ne samostatný, nesouvisející problém. Server, kterému dochází paměť nebo místo na disku, může ještě chvíli projít kontrolou dostupnosti, než nakonec spadne nebo se zpomalí do plazivého tempa, takže spoléhat se jen na monitoring dostupnosti znamená, že se o problému dozvíte až ve chvíli, kdy se z něj už stal výpadek. Kombinace obojího dává ucelenější obraz: monitoring dostupnosti potvrzuje, že web je právě dostupný, zatímco monitoring serveru sleduje trendy zdrojů, které předpovídají, jestli tomu tak zůstane i nadále.
Frekvence kontrol je nastavitelná podle toho, jak rychle potřebujete vědět o vznikajícím problému se zdroji. Placené tarify HostTracker podporují monitorovací intervaly až jednou za minutu, což se hodí pro servery s byznys-kritickými aplikacemi, kde je potřeba výkyv zdrojů rychle zachytit a řešit. Méně kritické nebo méně vytížené servery mohou používat delší interval a trvale bezplatný tarif kontroluje dva monitory každých 30 minut, což často stačí na zachycení trvalého trendu, jako je postupně se plnící místo na disku během několika dní, i když by nezachytil velmi krátký výkyv CPU. 30denní zkušební verze se všemi funkcemi bez nutnosti platební karty vám umožní vyzkoušet rychlejší kontrolní intervaly a zjistit, kolik podrobností vám výsledná data poskytnou, než se rozhodnete pro tarif.
Ne – žádného agenta HostTracker instalovat nemusíte, žádný démon udržovat v chodu a žádné přihlašovací údaje nikomu předávat. Kontrola zátěže serveru funguje opačně: váš server vystaví jeden malý endpoint jen pro čtení, který hlásí jedno číslo, a HostTracker si ho vyžádá v intervalu, který nastavíte. Máte tři možnosti, jak ho zajistit. Dvě jsou hotové skripty kolektoru, které vložíte na server, který už provozujete – jeden pro PHP na Linuxu nebo Unixu, druhý pro ASP.NET na IIS – a třetí je napsat si endpoint sám, což zabere zhruba deset řádků v jakémkoli jazyce: hodnotu přečtete, jak chcete, a odpovíte malým JSON objektem, který ji obsahuje. Tuto třetí možnost preferuje řada týmů, protože znamená, že na jejich stroji nikdy neběží nic, co sami nenapsali, a přesně rozhodují, jaká čísla jsou vystavená. Na váš server se nikdy nic automaticky nepushuje a HostTracker na něm nikdy neotevírá žádnou správní relaci.
Endpoint kolektoru musí být dosažitelný pro kontrolní body HostTracker, takže server za firewallem bez jakéhokoli příchozího přístupu nelze dotazovat přímo. V praxi je to menší překážka, než se zdá, protože to, co je potřeba vystavit, je jediná URL jen pro čtení, která vrací jedno číslo – ne SSH, ne správní port, ne monitorovací protokol. Obvyklé přístupy jsou publikovat endpoint na neuhodnutelné cestě, omezit ho na adresy, které z něj čtou, nebo ho umístit na stroj ve stejné síti, který už je přístupný z internetu, a nechat ho hlásit hodnoty za privátní host. Ať zvolíte cokoli, expozice je záměrně minimální: endpoint nepřijímá žádné příkazy, nic neměnící, a vrací jediné číslo. To je úplně jiná bezpečnostní úvaha než instalace agenta třetí strany s přístupem na úrovni systému, a přesně proto je kontrola navržená tímto způsobem.
Monitoring zátěže serveru – kontroly CPU, RAM a HDD – je jeden z 13 typů kontrol dostupných v rámci produktu HostTracker a trvale bezplatný tarif vám umožňuje sledovat dva servery nebo weby zdarma, s kontrolami každých 30 minut. HostTracker jako celek není čistě bezplatný produkt – jde o placenou monitorovací službu s bezplatným tarifem navíc – takže bezplatný tarif se dobře hodí na vyzkoušení monitoringu serveru na několika strojích nebo jako odlehčená možnost pro menší projekty, ne jako hlavní nabídka. Pro monitoring více serverů, kratší kontrolní intervaly nebo byznys-kritickou infrastrukturu, kde záleží na rychlejší detekci, začínají placené tarify zhruba na 5 USD měsíčně a 30denní zkušební verze se všemi funkcemi bez nutnosti platební karty vám umožní rychlejší intervaly vyzkoušet ještě před rozhodnutím.
Spusťte zkušební verzi zdarma a nechte se upozornit, když zátěž CPU, RAM nebo disku překročí vaše prahové hodnoty.
Součást softwaru pro monitorování webu HostTracker.