Naar hoofdinhoud springen

Monitoring van serverbelasting

Servermonitoringsoftware: controles voor CPU, RAM, schijf en SNMP

HostTrackers servermonitoring leest CPU-, RAM- en schijfbelasting van uw Linux- of Windows-server via een kleine collector-endpoint of SNMP, brengt de trend in kaart en waarschuwt u zodra een ingestelde drempel wordt overschreden, voordat de server omvalt.

  • Vertrouwd sinds 2004
  • 500.000+ gemonitorde websites
  • 300+ controlepunten wereldwijd

Hoe een servercontrole verloopt, van de collector tot de melding

Geen agent op uw serverUw server biedt één alleen-lezen endpoint dat een getal teruggeeft. HostTracker vraagt dit op volgens uw schema.
CPU, RAM, schijf en meerBelasting, geheugen, schijfruimte, de verbindingstijd van een poort, de responstijd van een database of elke Windows performance counter.
Twee drempels, een meldingEen waarschuwingsniveau en een kritiek niveau, gecontroleerd van elke 1 minuut tot elke 24 uur, met een debounce zodat één piek niemand oproept.

Drie manieren om het getal beschikbaar te stellen

Kies er een; er wordt niets naar uw machine gepusht.

Optie 1

De PHP-collector

Een kant-en-klaar script voor een Linux- of Unix-host die al PHP draait. Plaats het in een map die door de webserver wordt geserveerd en richt de monitor op die basis-URL. Het leest lokaal de eigen CPU-, geheugen- en schijfcijfers van de machine en antwoordt met het getal.

Optie 2

De ASP.NET-collector

Het Windows-equivalent, voor een host die IIS draait. Zelfde idee, met daarbij toegang tot elke Windows-prestatieteller op categorie, naam en instantie - alles wat Performance Monitor u lokaal kan laten zien, kan zo op afstand worden gemonitord.

Optie 3

Uw eigen endpoint

Richt de monitor op een willekeurige URL naar keuze en antwoord met een klein JSON-object. Tien regels in elke taal, niets op uw server dat u niet zelf hebt geschreven, en u bepaalt precies welke getallen worden blootgesteld. Dit is de optie waar de meeste engineeringteams uiteindelijk voor kiezen.

Servermonitoring

Schijfruimte, CPU en geheugen: spoor resourceproblemen op vóórdat ze downtime veroorzaken

CPU

CPU-belasting bijhouden

HostTracker bewaakt het CPU-gebruik om servers efficiënt en stabiel te houden. Het volgt het CPU-gebruik van uw server, signaleert problemen en waarschuwt u bij ongebruikelijke pieken. Het monitoren van de CPU-belasting helpt beheerders om hun servers soepel te laten draaien en downtime te voorkomen.

Geheugen

Geheugengebruikstrends

HostTracker bewaakt het geheugengebruik om de serverprestaties op peil te houden. Deze functie volgt het geheugengebruik en signaleert trends die tot vertragingen of crashes kunnen leiden. Rapporten en meldingen helpen beheerders het geheugengebruik te verbeteren. Goede RAM-monitoring betekent dat applicaties goed draaien en er geen verrassingen ontstaan door geheugenproblemen.

Schijf

Meldingen over schijfruimte

HDD-monitoring van HostTracker voorkomt opslagproblemen die de serverprestaties beïnvloeden. Deze dienst volgt het schijfruimtegebruik en waarschuwt beheerders om problemen zoals onvoldoende opslag of schijfstoringen te voorkomen. Monitoring en rapportage helpen u grip te houden op schijfruimteproblemen, zodat uw server altijd genoeg ruimte heeft om soepel te werken. Dit helpt servers betrouwbaar te houden en voorkomt gegevensverlies door opslagproblemen.

Wat een servermonitor vastlegt

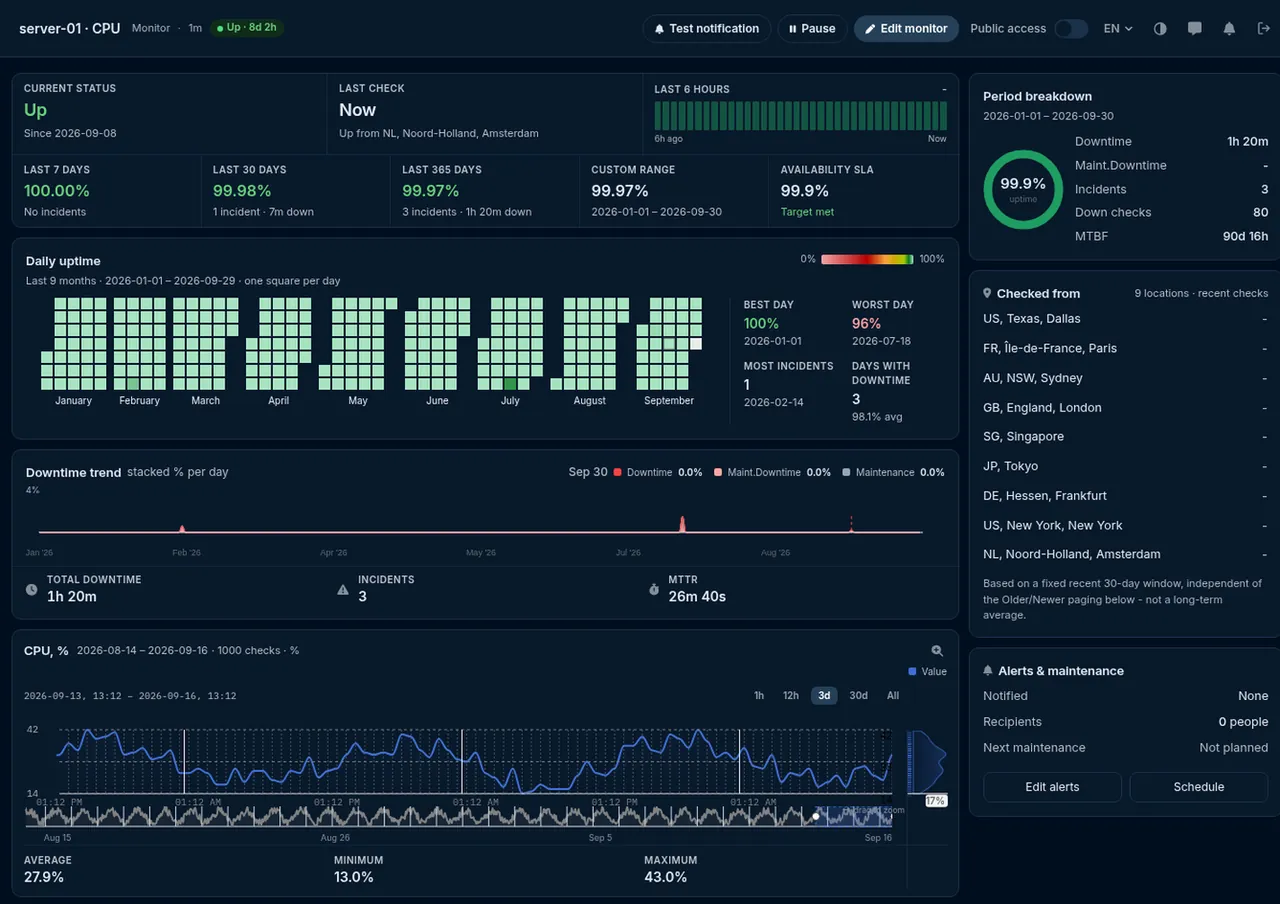
De waarde per controle tegenover beide drempels, zodat de trend lang voor de melding zichtbaar is.

De waardegrafiek

CPU, RAM of schijf in de tijd met de waarschuwings- en kritieke lijnen getekend - een vollopende schijf is een helling, geen verrassing.

Meldingen op het gekozen niveau

Waarschuwing en kritiek bereiken elk hun eigen contacten, na het aantal mislukte controles dat u instelde.

HostTracker server load monitor statistieken: de tellerwaarde in de tijd tegenover de drempels

Elke laag van uw stack, bewaakt

Websites, servers, API's, certificaten. Eén controletype per pagina, met dezelfde locaties, meldingen en rapporten erachter.

"Ik werk al lang met deze monitoringdienst en mijn dagelijkse routine is geen probleem meer. Hij houdt stilletjes al mijn sites in de gaten en laat me reageren zodra er iets misgaat."
Caleb Levy - Webmaster - CA - Trustpilot

Vertrouwd door teams bij

Microsoft Panasonic OTP Bank OneProvider Worldmate
De volledige gids

Servermonitoring uitgelegd

Elk hoofdstuk opent ter plekke, zodat de pagina kort blijft.

Hoe de cijfers bij HostTracker terechtkomen - zonder agent op uw server

De meeste servermonitoringproducten vragen u om een agent te installeren: een achtergrondproces met systeemniveau-toegang dat permanent op uw machine draait en gegevens naar buiten stuurt. HostTracker doet dat bewust niet. Het is een externe monitoringdienst, en een servercheck werkt precies andersom - uw server stelt één klein alleen-lezen endpoint beschikbaar dat één enkel getal rapporteert, en HostTracker vraagt dat getal op volgens het schema dat u instelt.

Die omkering is het hele ontwerp. Er is geen daemon die in leven moet worden gehouden, geen bevoorrechte software die u niet zelf hebt geschreven draait op productie, geen inloggegevens die aan een derde partij worden overhandigd, en geen inkomende beheerpoort. Wat u blootstelt is een URL die geen commando's accepteert, niets wijzigt en één waarde teruggeeft.

Er wordt nooit iets naar uw machine gepusht. De collector wordt door uzelf geplaatst, wanneer u dat wilt, en HostTracker doet er alleen ooit een verzoek naartoe. Als u de collector verwijdert, stopt de monitoring - er is geen andere manier naar binnen.

Servergezondheidsmonitoring: wat een servermonitor kan meten

Elke monitor bewaakt één waarde, dus een typische server eindigt met drie of vier monitors - en elke krijgt zijn eigen drempelwaarde, eigen geschiedenis en eigen melding. De beschikbare waardetypen zijn:

MetricGerapporteerd alsWaar het goed voor is
CPUGebruikspercentageAanhoudende verzadiging, losgeslagen processen, te kleine instances, de belasting die een release heeft toegevoegd
RAMGebruikspercentageGeheugenlekken, sluipend toenemend verbruik tussen herstarts, de druk die voorafgaat aan het geheugentekort dat een proces laat killen
SchijfGebruikspercentage voor een pad of station dat u opgeeftLogs, uploads en back-ups die een volume vullen - de traagste en meest voorspelbare storing die er is
TCP-poortVerbindingstijd in millisecondenOf een dienst op de machine nog verbindingen accepteert, en hoe snel
SQL ServerVerbindingstijd in millisecondenDatabasebereikbaarheid en authenticatie vanuit het perspectief van de server zelf
MySQLVerbindingstijd in millisecondenHetzelfde, voor MySQL
Windows-prestatietellerWat de teller ook rapporteertAlles wat Performance Monitor blootgeeft, op categorie, tellernaam en instantie - wachtrijlengtes, handles, cijfers per proces

Als u niet de verbindingstijd nodig hebt maar de database áchter de server, dan is dat een andere, diepere check: een databasequerymonitor maakt verbinding, authenticeert, voert een query uit die u zelf schrijft en vergelijkt de teruggegeven waarde met een drempelwaarde.

Uw eigen collector schrijven

Het contract is bewust triviaal, want het punt is juist dat u het in één keer kunt doorlezen en implementeren in welke taal uw team ook al gebruikt. HostTracker vraagt uw URL op; uw endpoint antwoordt met een JSON-object dat de waarde bevat:

{ "v": 42.7 }

Dat is het volledige vereiste oppervlak. Twee optionele velden maken het resultaat nuttiger: e bevat een foutmelding wanneer de waarde deze keer niet kon worden gelezen - een veel beter resultaat dan het rapporteren van een misleidende nul - en vs bevat een eigen versienummer, dat in het resultaat verschijnt zodat u kunt zien welke build van de collector heeft geantwoord.

{ "v": 91.4, "e": "", "vs": "collector-2.1" }

Omdat u zelf de lezer schrijft, bent u niet beperkt tot wat een generieke agent weet te verzamelen. Wachtrijdiepte, cache-hitratio, het aantal wachtende taken, de leeftijd van het oudste onverwerkte record, vrije inodes, de grootte van een map die nooit mag groeien - alles wat u als getal kunt uitdrukken, wordt een gemonitorde waarde met drempelwaarden, geschiedenis en meldingen eraan gekoppeld.

Bescherm het endpoint. Het moet bereikbaar zijn voor de checkers die het aanroepen, dus behandel het als elke andere publieke URL: plaats het op een niet te raden pad, houd het alleen-lezen, en stel alleen de getallen bloot waarvan u het prettig vindt dat ze gelezen worden. Het accepteert geen parameters die iets wijzigen, waardoor de blootstelling beperkt blijft tot precies één waarde.

Een drempelwaarde instellen die ergens op slaat

Een ruw getal is data; een drempelwaarde is wat er monitoring van maakt. Elke monitor heeft een voorwaarde en één of twee limieten, zodat u de vorm van "fout" kunt uitdrukken in plaats van alleen een plafond:

  • groter dan of kleiner dan een limiet - de alledaagse vorm. CPU boven 90. Vrije schijfruimte onder 10.
  • gelijk aan of ongelijk aan een limiet - voor een waarde die eigenlijk een status is: een aantal workers dat op 4 moet blijven staan, een vlag die op 0 moet blijven staan.
  • binnen een bereik of buiten een bereik, met twee limieten - de juiste vorm voor alles met een gezonde bandbreedte in plaats van een gezond maximum. Een wachtrij die normaal tussen de 10 en 500 zit, vertelt u iets wanneer die 0 aangeeft, en iets anders wanneer die 5.000 aangeeft.
  • geen voorwaarde - verzamel en grafiek de waarde zonder de check ooit te laten falen. Nuttig voor een metric waarvan u geschiedenis wilt opbouwen voordat u weet hoe "slecht" eruitziet.

De debounce-instelling is wat de ruis stopt

Naast de drempelwaarde staat een aantal opeenvolgende overbelaste checks voordat de monitor down gaat, instelbaar van nul tot twintig. Het is verreweg de waardevolste instelling op de pagina, en degene die het vaakst ongemoeid wordt gelaten. Een server op 95% CPU voor één meting tijdens een nachtelijke back-up is geen incident. Een server op 95% voor vijf opeenvolgende checks is dat wel. Stel het aantal in op hoe lang uw workload legitiem druk mag zijn, en een hele categorie vals alarm om drie uur 's nachts verdwijnt, zonder dat uw drempelwaarde ook maar iets minder streng wordt.

Dit is hier belangrijker dan bij een webcheck, omdat een servermetric wordt gelezen uit één gezaghebbende bron - uw eigen collector - in plaats van bevestigd te worden over meerdere onafhankelijke checkpoints zoals bij een beschikbaarheidscheck. Er is geen tweede mening om een momentane piek uit te middelen, dus die rol wordt vervuld door het aantal opeenvolgende checks.

Waar elke metric u voor waarschuwt

De drie kernmetrics falen op werkelijk verschillende manieren, en weten welke u bekijkt, vertelt u hoeveel tijd u heeft.

MetricHoe de storing zich aandientHoeveel waarschuwingstijd u krijgt
CPUEr gaat niets kapot. Alles wordt langzamer - elk verzoek, elke query, elke achtergrondtaak - en de site verslechtert lang voordat hij omvalt.Meestal genoeg, als u kijkt. Een aanhoudende stijging is uren of dagen zichtbaar voordat gebruikers er iets van merken.
RAMPlotseling en heftig. Applicaties worden door het besturingssysteem gekilld om geheugen vrij te maken, herstarten en worden opnieuw gekilld - precies de sporadische, niet-reproduceerbare uitval die het lastigst te diagnosticeren is.Weinig, pas op het eind. Maar de langzame stijging van een geheugenlek tussen herstarts is een van de meest leesbare signalen in monitoring, als de geschiedenis er is.
SchijfAlles tegelijk. Logs stoppen met schrijven, de database weigert schrijfacties, sessies mislukken, tijdelijke bestanden kunnen niet worden aangemaakt - en de oorzaak is onzichtbaar in de eigen foutmeldingen van de applicatie.De meeste waarschuwingstijd van allemaal, en het vaakst gemist. Een volume dat gestaag vol raakt, is dagen van tevoren te voorspellen.
VerbindingstijdEen afhankelijkheid waar de server op leunt, is traag of onbereikbaar geworden, nog voordat dat als volledige storing zichtbaar is.Vaak het vroegste signaal dat er iets mis is verderop in de keten.

Schijf verdient zijn reputatie als de klassieke, vermijdbare storing. Het is de ene storing die een monitor met een drempelwaarde en een week aan geschiedenis altijd het eerst opmerkt, en degene die achteraf het gênantst is om uit te leggen.

Lees de trend, niet alleen de melding

Elke meting wordt opgeslagen, dus elke servermonitor heeft een grafiek van zijn eigen waarde over tijd, met het gemiddelde, minimum en maximum voor het venster dat u bekijkt. Percentages worden als percentages weergegeven en verbindingstijden in milliseconden, zodat een CPU-monitor en een databaselatentiemonitor allebei leesbaar zijn zoals u zou verwachten.

De melding vertelt u dat er een lijn is overschreden; de grafiek vertelt u de twee dingen die u daarna echt nodig hebt. Is dit nieuw? - een piek die op zichzelf alarmerend lijkt, is vaak dezelfde piek die al een jaar elke dinsdag om 02:00 uur voorkomt. En waar gaat het naartoe? - een geheugencijfer dat gestaag stijgt tussen herstarts in, is een lek, wat de huidige waarde ook is, en een schijf die twee procent per week stijgt, heeft een datum eraan vast.

Die tweede vraag is het capaciteitsplanningsgebruik van servermonitoring, en het is de reden om te beginnen met het verzamelen van een metric voordat u weet welke drempelwaarde erop moet. U kunt de drempelwaarde over een maand toevoegen, zodra de geschiedenis heeft laten zien hoe normaal eruitziet. De geschiedenis die u niet heeft verzameld, is degene die u niet meer kunt terughalen.

Servermonitoring en uptime-monitoring beantwoorden verschillende vragen

Ze vullen elkaar aan, ze zijn geen alternatieven voor elkaar, en het onderscheid is duidelijk genoeg om expliciet te benoemen.

Uptime-monitoringServermonitoring
De vraag die het beantwoordtKan een bezoeker de site op dit moment bereiken?Is de machine eronder gezond genoeg om te blijven antwoorden?
Vanwaar het kijktVan buitenaf - 300+ checkpoints in 158 stedenVan binnenuit - een waarde gelezen op de machine zelf
Typische timingVertelt u het op het moment van de storingVertelt u het vóór de storing, als u de drempelwaarde onder de afgrond zet
Beheersing van vals alarmEen mislukte waarneming wordt vanaf andere checkpoints opnieuw gecontroleerd en door een quorum bevestigdEén gezaghebbende meting, met een aantal opeenvolgende overbelastingen als debounce
Signaleert een geheugenlekNee - totdat het uiteindelijk iets laat crashenJa - als trend, weken eerder
Signaleert een netwerkroutestoring tussen uw gebruikers en uJaNee - de machine voelt zich prima

Als u er maar één van gebruikt, blijft er in beide richtingen een echt gat over. De combinatie waar de meeste accounts op uitkomen, is een beschikbaarheidscheck van één minuut vanaf meerdere locaties plus een handvol servermonitors op CPU, geheugen en het volume dat het meest waarschijnlijk vol raakt.

SNMP-monitoring, voor hardware die nooit een collector zal draaien

Routers, switches, firewalls, UPS-apparaten en printers kunnen geen script hosten, maar bijna allemaal spreken ze al SNMP. Een aparte SNMP-check leest rechtstreeks een numerieke waarde van het apparaat af via een OID - interfacetellers, temperatuur, belasting, uptime, batterijniveau - over SNMP v1, v2c of v3, inclusief v3 met authenticatie en privacy zodat inloggegevens niet onversleuteld worden verstuurd.

Om helder te zijn over waar dit vandaag staat: een SNMP-check leest en registreert de waarde die het apparaat rapporteert. Meldingen op basis van een drempelwaarde voor een SNMP-waarde zijn nog niet beschikbaar - wanneer u wilt dat een getal daadwerkelijk een incident veroorzaakt, gebruik dan een servermonitor tegen een collector, die het volledige voorwaarde- en debouncemodel hierboven heeft.

Servermonitoring instellen

  1. Bepaal wat u blootstelt. Als uw server al PHP of IIS draait, is de bijpassende kant-en-klare collector de snelste weg; schrijf anders zelf het endpoint - het geeft één getal terug.
  2. Plaats het op de server die u wilt bewaken en controleer of u het zelf kunt opvragen. Zet het op een niet te raden pad. Als de machine nieuw is, zijn de gratis TCP-poortcheck en de gratis pingtest een snelle manier om te bevestigen dat de machine vanaf de buitenwereld bereikbaar is voordat u verdergaat - geen login vereist.
  3. Voeg een monitor van het type CPU, RAM, HDD monitoren toe, kies welke waarde deze uitleest, en geef de URL van de collector op. Geef bij een schijfmonitor het pad of station op; geef bij een databaseverbindingstijdmonitor de verbindingsgegevens op die de collector moet gebruiken.
  4. Stel de voorwaarde en de limieten in - en stel het aantal overbelastingen voor down bewust in in plaats van het op de standaardwaarde te laten staan. Dit is de instelling die bepaalt of de monitor nuttig is of genegeerd wordt.
  5. Kies een interval, ergens tussen één minuut en 24 uur. Eén minuut past bij een machine die iets bedrijfskritisch draait; 5 of 10 minuten is ruim voldoende voor een trend zoals schijfgebruik.
  6. Herhaal dit voor elke waarde die op die host belangrijk is - CPU, geheugen en het volume dat het meest waarschijnlijk vol raakt, is een verstandige startset - en voeg vervolgens de contacten toe die hiervan op de hoogte moeten worden gebracht.
  7. Wacht een week voordat u iets bijstelt. De eerste week aan geschiedenis vertelt u of uw drempelwaarde klopt, en dat is veel beter bewijs dan een gok op dag één.

Beperkingen die het weten waard zijn

  • De collector moet bereikbaar zijn. Een host zonder enige inkomende toegang kan niet worden bevraagd. Wat moet worden blootgesteld is één alleen-lezen URL, geen beheerpoort - maar het moet wel worden blootgesteld.
  • Eén monitor bewaakt één waarde. CPU, geheugen en schijf zijn drie monitors, elk met een eigen drempelwaarde en eigen geschiedenis. Dat maakt de meldingen precies, en het betekent wel dat een drukke server meerdere monitorplekken gebruikt.
  • Windows-prestatietellers vereisen de ASP.NET-collector. De combinatie categorie/naam/instantie wordt lokaal door die collector uitgelezen; een PHP-host rapporteert in plaats daarvan CPU, geheugen, schijf en verbindingstijden.
  • Er is geen bevestiging vanaf meerdere locaties. In tegenstelling tot een beschikbaarheidscheck komt een servermetric uit één gezaghebbende bron, dus een enkele afwijkende meting is een echte meting. Het aantal opeenvolgende overbelastingen is daar het middel voor, en het is de moeite waard om dit in te stellen.
  • Het rapporteert wat de collector rapporteert. Als uw eigen endpoint een bug bevat, meldt de monitor trouw het verkeerde getal - daarom is het optionele foutveld in het antwoord belangrijk: rapporteer een fout in plaats van een nul.
  • Geen netwerkdoorvoerteller. De beschikbare waarden zijn CPU, geheugen, schijfgebruik, verbindingstijden en Windows-prestatietellers; bandbreedte zit daar niet bij. Voor een apparaat dat doorvoer via SNMP rapporteert, kan een SNMP-check die teller uitlezen en in een grafiek zetten.

Veelgestelde vragen

Servermonitoring is het doorlopend volgen van het resourcegebruik van uw server - CPU-belasting, RAM-gebruik (geheugen) en HDD-belasting (schijf) - zodat u ziet hoe uw infrastructuur daadwerkelijk presteert, in plaats van alleen of de website erbovenop reageert. De servermonitoring van HostTracker controleert deze drie metrics en rapporteert trends en pieken over tijd, wat belangrijk is omdat uitputting van resources een van de meest voorkomende oorzaken is van trage prestaties, crashes en regelrechte downtime. Een server kan technisch "online" zijn en toch op het punt staan om uit te vallen als het CPU-gebruik piekt, het geheugen bijna vol zit of de schijfruimte kritiek laag is - niets waarvan een eenvoudige beschikbaarheidscheck noodzakelijkerwijs zou opmerken totdat het probleem daadwerkelijk zichtbare uitval veroorzaakt.

Een server kan bereikbaar en technisch online blijven terwijl hij gevaarlijk dicht bij zijn resourcelimieten draait, wat betekent dat een hoog CPU- of RAM-gebruik vaak een vroege waarschuwing is voor een probleem in plaats van het probleem zelf. Aanhoudend hoge CPU-belasting vertraagt elk verzoek dat de server verwerkt, wat de ervaring voor elke bezoeker verslechtert, ook al gaat de site nooit volledig plat. Geheugendruk is nog gevaarlijker - naarmate het RAM-gebruik richting de capaciteit klimt, kunnen applicaties gaan crashen, herstarten of door het besturingssysteem worden afgesloten om geheugen vrij te maken, wat vaak leidt tot de moeilijk te diagnosticeren, incidentele uitval die eerder op willekeurige storingen lijkt dan op een duidelijke fout. Door verhoogd CPU- of RAM-gebruik via servermonitoring te signaleren voordat het escaleert tot een crash, krijgen beheerders de tijd om proactief te onderzoeken en capaciteit toe te voegen.

Wanneer CPU-, RAM- of schijfbelastingmonitoring ongebruikelijke activiteit detecteert - een aanhoudende piek, geheugen dat richting de capaciteit klimt, of schijfruimte die opraakt - stuurt HostTracker een melding via een van de 9 alertkanalen die u heeft ingesteld, waaronder e-mail, sms, spraakoproep, webhooks, Slack en berichten-apps zoals Telegram, Discord en Viber. Dit betekent dat de persoon die verantwoordelijk is voor de serverinfrastructuur direct op de hoogte is van een ontstaand resourceprobleem, in plaats van het pas te ontdekken nadat het al vertraging of een crash heeft veroorzaakt die klanten merken. Omdat rapporten en meldingen automatisch worden gegenereerd uit de gemonitorde gegevens, krijgen beheerders naast de realtime melding ook een gedocumenteerde geschiedenis van resourcetrends, wat helpt om een eenmalige piek te onderscheiden van een echt capaciteitsprobleem dat een structurelere oplossing nodig heeft.

Uptime-monitoring beantwoordt een smallere vraag: is de website of dienst op dit moment bereikbaar en reageert deze. Servermonitoring kijkt onder dat oppervlak naar de infrastructuur die de site daadwerkelijk draait - CPU-belasting, geheugengebruik en schijfruimte - die vaak de onderliggende oorzaak zijn van een uptime-storing in plaats van een apart, ongerelateerd probleem. Een server met weinig geheugen of schijfruimte kan een tijdje gewoon door een uptime-check komen voordat hij uiteindelijk crasht of tot stilstand komt, dus als u alleen op uptime-monitoring vertrouwt, ontdekt u het probleem pas nadat het al tot uitval is geëscaleerd. De combinatie van beide geeft een vollediger beeld: uptime-monitoring bevestigt dat de site op dit moment bereikbaar is, terwijl servermonitoring de onderliggende resourcetrends volgt die voorspellen of dat zo blijft.

De controlefrequentie is instelbaar, afgestemd op hoe snel u een ontstaand resourceprobleem wilt weten. De betaalde plannen van HostTracker ondersteunen controle-intervallen tot wel eens per minuut, wat nuttig is voor servers met bedrijfskritische applicaties waarbij een resourcepiek snel moet worden opgemerkt en aangepakt. Minder kritieke of minder drukke servers kunnen een langer interval gebruiken, en het permanent gratis abonnement controleert twee monitors elke 30 minuten, wat vaak genoeg is om een aanhoudende trend te signaleren, zoals schijfruimte die dagenlang gestaag volloopt, ook al zou het een zeer kortstondige CPU-piek niet opmerken. Met een gratis proefperiode van 30 dagen met alle functies en zonder creditcard kunt u snellere controle-intervallen uitproberen en zien hoeveel detail de resulterende gegevens bieden voordat u een abonnement kiest.

Nee - er is geen HostTracker-agent om te installeren, geen daemon die moet blijven draaien en geen inloggegevens die u hoeft af te staan. Een servercheck werkt precies andersom: uw server stelt één klein alleen-lezen endpoint beschikbaar dat één enkel getal rapporteert, en HostTracker vraagt dat getal op volgens het schema dat u instelt. U heeft drie manieren om dit aan te leveren. Twee daarvan zijn kant-en-klare collectorscripts die u op een server plaatst die u al draait - één voor PHP op Linux of Unix, één voor ASP.NET op IIS - en de derde is om het endpoint zelf te schrijven, wat ongeveer tien regels kost in elke taal: lees de waarde op de manier die u wilt en antwoord met een klein JSON-object dat de waarde bevat. Die derde optie is degene die veel teams het liefst gebruiken, omdat dan nooit iets draait op hun machine dat ze niet zelf hebben geschreven, en zij precies bepalen welke getallen worden blootgesteld. Er wordt nooit automatisch iets naar uw server gepusht, en HostTracker opent er nooit een beheersessie op.

Het collector-endpoint moet bereikbaar zijn voor de checkers van HostTracker, dus een server achter een firewall zonder enige inkomende toegang kan niet rechtstreeks worden bevraagd. In de praktijk is dit een kleiner obstakel dan het klinkt, want wat moet worden blootgesteld is één alleen-lezen URL die één getal teruggeeft - geen SSH, geen beheerpoort, geen monitoringprotocol. De gebruikelijke aanpakken zijn: het endpoint publiceren op een niet te raden pad, het beperken tot de adressen die het aanroepen, of het hosten op een machine in hetzelfde netwerk die al wel internetbereikbaar is en die namens de private host rapporteert. Wat u ook kiest, de blootstelling is bewust minimaal: het endpoint accepteert geen commando's, wijzigt niets en geeft één enkel getal terug. Dat is een heel ander beveiligingsvraagstuk dan het installeren van een externe agent met systeemniveau-toegang, en precies daarom is de check op deze manier ontworpen.

Monitoring van de serverbelasting - CPU-, RAM- en HDD-checks - is een van de 13 controletypes binnen het HostTracker-product, en het permanent gratis abonnement laat u twee servers of sites gratis monitoren, met controles elke 30 minuten. HostTracker als geheel is geen gratis-only product - het is een betaalde monitoringdienst met een gratis laag ernaast - dus het gratis abonnement werkt goed om servermonitoring op een paar machines uit te proberen of als lichte optie voor kleinere projecten, niet als het primaire aanbod. Voor het monitoren van meer servers, kortere controle-intervallen of bedrijfskritische infrastructuur waar snellere detectie belangrijk is, beginnen betaalde abonnementen rond $5 per maand, en met een gratis proefperiode van 30 dagen met alle functies en zonder creditcard kunt u de snellere intervallen testen voordat u beslist.

30 dagen gratis proefperiode - geen creditcard nodig

Voorkom serveroverbelasting vóórdat u eronder gaat

Start een gratis proefperiode en ontvang een melding zodra CPU-, RAM- of schijfbelasting uw drempelwaarden overschrijdt.

30 dagen gratis proberen - 100 monitors - geen creditcard
  • Vertrouwd sinds 2004
  • 500.000+ gemonitorde websites
  • 300+ controlepunten wereldwijd

Onderdeel van de website monitoring software van HostTracker.