Перейти к основному содержимому

Мониторинг нагрузки сервера

Программа для мониторинга серверов: CPU, RAM, диск и SNMP

Мониторинг сервера от HostTracker считывает нагрузку CPU, RAM и диска с вашего сервера на Linux или Windows через лёгкий коллектор или SNMP, строит график тренда и оповещает вас при превышении заданного порога - до того, как сервер выйдет из строя.

  • Нам доверяют с 2004 года
  • 500 000+ отслеживаемых сайтов
  • 300+ контрольных точек по всему миру

Как проходит одна проверка нагрузки сервера: от коллектора до оповещения

Без агента на Вашем сервереВаш сервер предоставляет одну конечную точку только для чтения, которая возвращает число. HostTracker запрашивает ее по заданному Вами расписанию.
CPU, RAM, диск и другоеНагрузка, память, место на диске, время подключения к порту, время отклика базы данных или любой счетчик производительности Windows.
Два порога, одно оповещениеУровень предупреждения и критический уровень проверяются с интервалом от 1 минуты до 24 часов, с задержкой подтверждения, чтобы один всплеск никого не оповещал.

Три способа предоставить число

Выберите один из них; на Вашу машину ничего не отправляется.

Вариант 1

Коллектор на PHP

Готовый скрипт для хоста на Linux или Unix, где уже работает PHP. Разместите его в каталоге, обслуживаемом веб-сервером, и укажите монитору этот базовый URL. Он локально считывает показатели CPU, памяти и диска самой машины и отвечает числом.

Вариант 2

Коллектор на ASP.NET

Аналог для Windows, для хоста с IIS. Та же идея, плюс доступ к любому счётчику производительности Windows по категории, имени и экземпляру - так что всё, что локально показывает Performance Monitor, можно отслеживать удалённо.

Вариант 3

Собственная конечная точка

Укажите монитору любой удобный вам URL и отвечайте небольшим JSON-объектом. Десять строк на любом языке, ничего на вашем сервере, что вы не написали сами, и вы точно решаете, какие числа раскрываются. Этот вариант в итоге предпочитает большинство инженерных команд.

Мониторинг сервера

Место на диске, CPU и память: замечайте проблемы с ресурсами до того, как они приведут к простою

CPU

Отслеживание нагрузки CPU

HostTracker следит за загрузкой CPU, помогая серверам работать эффективно и стабильно. Сервис отслеживает загрузку процессора вашего сервера, выявляя проблемы и оповещая о необычных всплесках. Мониторинг нагрузки CPU помогает администраторам поддерживать бесперебойную работу серверов и предотвращать простои.

Память

Тренды использования памяти

HostTracker отслеживает использование памяти, помогая поддерживать производительность сервера. Эта функция отслеживает использование памяти и выявляет тренды, которые могут привести к замедлению или сбоям. Отчёты и оповещения помогают администраторам оптимизировать использование памяти. Качественный мониторинг RAM означает, что приложения работают стабильно и не преподносят сюрпризов из-за проблем с памятью.

Диск

Оповещения о нехватке места на диске

Мониторинг HDD от HostTracker предотвращает проблемы с хранилищем, влияющие на производительность сервера. Сервис отслеживает использование дискового пространства и оповещает администраторов, чтобы предотвратить проблемы вроде нехватки места или сбоев диска. Мониторинг и отчётность помогают держать ситуацию с местом на диске под контролем, чтобы серверу всегда хватало пространства для стабильной работы. Это помогает поддерживать надёжность серверов и предотвращает потерю данных из-за проблем с хранилищем.

Что фиксирует монитор сервера

Значение при каждой проверке относительно обоих порогов, поэтому тенденция видна задолго до оповещения.

График значений

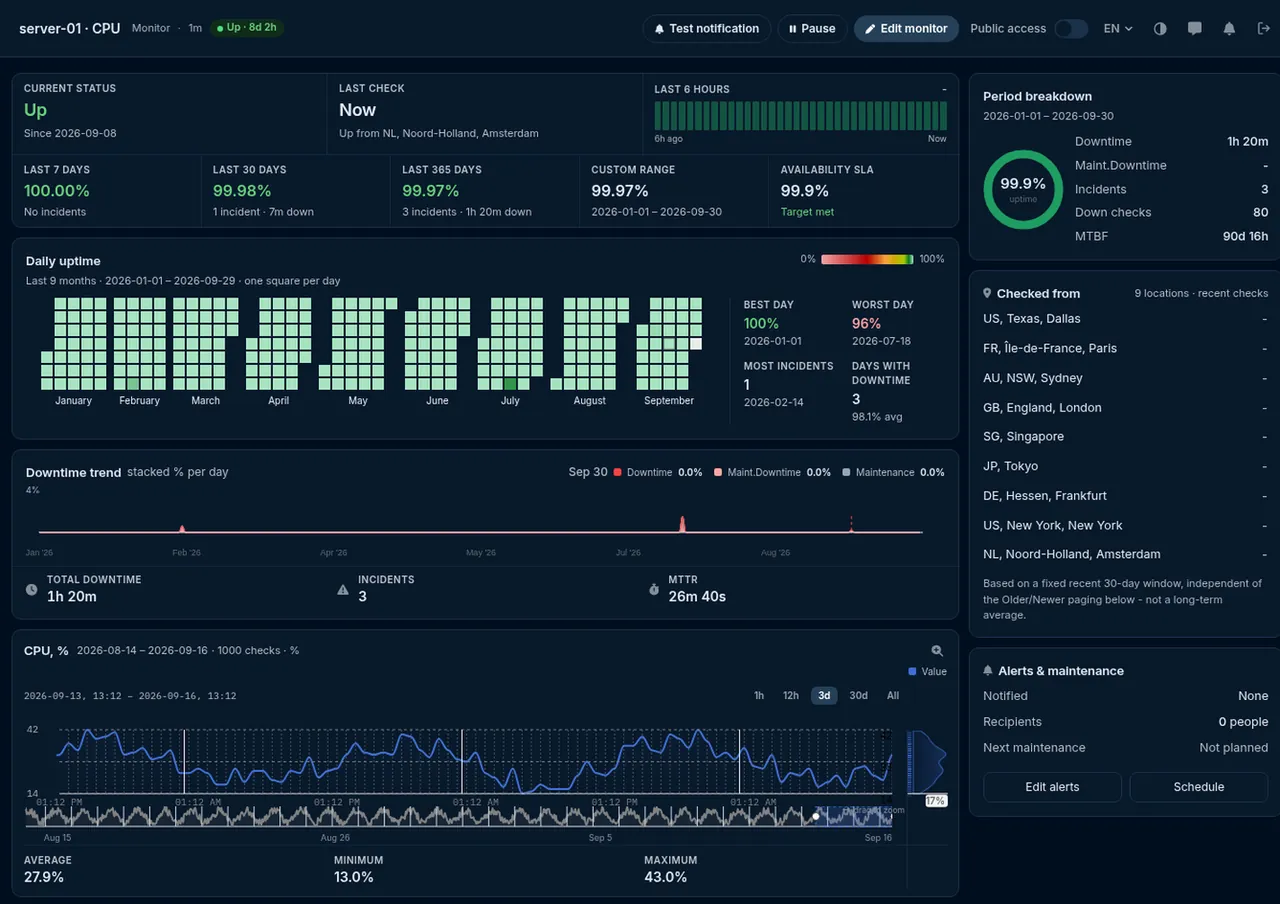
CPU, RAM или диск во времени с нанесенными линиями предупреждения и критического уровня: заполнение диска видно как наклон графика, а не как неожиданность.

Оповещения на выбранном Вами уровне

Предупреждение и критический уровень оповещают свои собственные контакты после заданного Вами числа неудачных проверок.

Статистика монитора нагрузки сервера HostTracker: значение счетчика во времени относительно его порогов

Каждый уровень вашей инфраструктуры под наблюдением

Сайты, серверы, API, сертификаты. Один тип проверки на страницу, за всеми - те же локации, оповещения и отчёты.

"Я давно пользуюсь этим сервисом мониторинга, и моя повседневная рутина перестала быть проблемой. Он тихо следит за всеми моими сайтами и позволяет мне реагировать в тот момент, когда что-то идёт не так."
Caleb Levy - Webmaster - CA - Trustpilot

Нам доверяют команды из

Microsoft Panasonic OTP Bank OneProvider Worldmate
Полное руководство

Мониторинг сервера: подробное объяснение

Каждая глава раскрывается на месте, поэтому страница остается короткой.

Как показатели попадают в HostTracker - без агента на вашем сервере

Большинство продуктов для мониторинга серверов просят вас установить агент: фоновый процесс с доступом на уровне системы, который постоянно работает на вашей машине и передаёт данные наружу. HostTracker намеренно этого не делает. Это внешний сервис мониторинга, и проверка нагрузки сервера работает наоборот - ваш сервер открывает одну небольшую конечную точку, доступную только на чтение, которая сообщает одно число, а HostTracker запрашивает её по заданному вами расписанию.

Именно в этой инверсии весь замысел. Не нужен постоянно работающий демон, не нужно привилегированное ПО, которое вы не писали, работающее в продакшене, не нужно передавать учётные данные третьей стороне, и не нужен входящий порт управления. Всё, что вы раскрываете, - это URL, который не принимает никаких команд, ничего не меняет и возвращает одно значение.

Ничего никогда не отправляется на вашу машину. Коллектор развёртываете вы сами, когда захотите, а HostTracker только делает к нему запросы. Если вы его удалите, мониторинг остановится - другого пути внутрь у него нет.

Мониторинг состояния сервера: что может измерять серверный монитор

Каждый монитор следит за одним значением, поэтому у типичного сервера в итоге оказывается три-четыре монитора, и у каждого - собственный порог, собственная история и собственное оповещение. Типы значений таковы:

МетрикаОтображается какДля чего это полезно
CPUПроцент загрузкиУстойчивое насыщение, вышедшие из-под контроля процессы, недостаточные по мощности инстансы, нагрузка, добавленная релизом
RAMПроцент использованияУтечки памяти, постепенное накопление потребления между перезапусками, давление, предшествующее принудительному завершению из-за нехватки памяти
ДискПроцент использования для указанного вами пути или дискаЛоги, загрузки и бэкапы, заполняющие том - самый медленный и самый предсказуемый простой из всех
TCP-портВремя подключения в миллисекундахПринимает ли ещё соединения сервис на машине и насколько быстро
SQL ServerВремя подключения в миллисекундахДоступность базы данных и аутентификация с точки зрения самого сервера
MySQLВремя подключения в миллисекундахТо же самое, для MySQL
Счётчик производительности WindowsВсё, что сообщает счётчикВсё, что предоставляет Performance Monitor, по категории, имени счётчика и экземпляру - длины очередей, дескрипторы, показатели по процессам

Если вам нужна именно база данных за сервером, а не время подключения к ней, это другая, более глубокая проверка: монитор запросов к базе данных подключается, аутентифицируется, выполняет написанный вами запрос и сравнивает возвращённое значение с порогом.

Написание собственного коллектора

Контракт намеренно тривиален, потому что смысл в том, чтобы прочитать его за один присест и реализовать на любом языке, который уже использует ваша команда. HostTracker запрашивает ваш URL; ваша конечная точка отвечает JSON-объектом со значением:

{ "v": 42.7 }

Это весь обязательный набор полей. Два опциональных поля делают результат полезнее: e несёт строку с ошибкой, если значение не удалось считать в этот раз - гораздо лучший исход, чем сообщить вводящий в заблуждение ноль, - а vs несёт собственную строку версии, которая показывается в результате, чтобы вы могли понять, какая сборка коллектора ответила.

{ "v": 91.4, "e": "", "vs": "collector-2.1" }

Поскольку читатель значения пишете вы сами, вы не ограничены тем, что умеет собирать типовой агент. Глубина очереди, коэффициент попаданий в кеш, число ожидающих задач, возраст самой старой необработанной записи, свободные inode, размер каталога, который никогда не должен расти, - всё, что можно выразить числом, становится отслеживаемым значением со своими порогами, историей и оповещениями.

Защитите конечную точку. Она должна быть доступна для чекеров, которые к ней обращаются, так что относитесь к ней как к любому другому публичному URL: разместите её по непредсказуемому пути, держите её доступной только на чтение и раскрывайте только те числа, которые вам не жаль показать. Она не принимает параметров, которые что-либо меняют, что ограничивает раскрываемую поверхность ровно одним значением.

Настройка порога, который что-то значит

Сырое число - это данные; порог - это то, что превращает их в мониторинг. Каждый монитор несёт условие и один или два лимита, так что вы можете описать форму «неправильного», а не просто потолок:

  • больше чем или меньше чем лимит - повседневная форма. CPU выше 90. Свободное место на диске ниже 10.
  • равно или не равно лимиту - для значения, которое на самом деле является состоянием: число воркеров, которое должно оставаться равным 4, флаг, который должен оставаться равным 0.
  • внутри диапазона или вне диапазона, с двумя лимитами - подходящая форма для всего, у чего есть здоровый диапазон, а не просто здоровый максимум. Очередь, которая в норме содержит от 10 до 500 элементов, сообщает вам кое-что, когда показывает 0, и совсем другое, когда показывает 5000.
  • без условия вообще - собирать и строить график значения, никогда не проваливая проверку. Полезно для метрики, по которой вы хотите сначала накопить историю, прежде чем понять, как выглядит «плохо».

Дебаунс - это настройка, которая останавливает шум

Рядом с порогом стоит счётчик подряд идущих перегруженных проверок до перехода монитора в состояние «недоступен», регулируемый от нуля до двадцати. Это самый ценный параметр на странице и самый часто оставляемый без внимания. Сервер с загрузкой CPU 95% в течение одного замера во время ночного бэкапа - это не инцидент. Сервер с загрузкой 95% пять проверок подряд - это уже инцидент. Настройте счётчик так, чтобы он соответствовал тому, как долго ваша нагрузка законно может быть высокой, и целая категория ложных тревог в три часа ночи исчезнет без того, чтобы ваш порог стал менее строгим.

Здесь это важнее, чем в веб-проверке, потому что серверная метрика считывается из одного авторитетного источника - вашего собственного коллектора, - а не подтверждается несколькими независимыми чекпоинтами, как это делается в проверке доступности. Здесь нет второго мнения, которое сгладило бы кратковременный всплеск, и именно счётчик дебаунса играет эту роль.

О чём предупреждает каждая метрика

Три основные метрики выходят из строя по-настоящему разными способами, и понимание того, на какую из них вы смотрите, говорит о том, сколько у вас времени.

МетрикаКак наступает сбойСколько времени на предупреждение
CPUНичего не ломается. Всё замедляется - каждый запрос, каждый запрос к базе, каждая фоновая задача - и сайт деградирует задолго до того, как окончательно откажет.Обычно достаточно, если вы наблюдаете. Устойчивый рост виден часами или днями, прежде чем становится заметным пользователям.
RAMРезко и жёстко. Приложения принудительно завершаются операционной системой для освобождения памяти, перезапускаются и снова завершаются - именно это создаёт прерывистый, невоспроизводимый сбой, который труднее всего диагностировать.Мало, и только в самом конце. Но медленный рост утечки памяти между перезапусками - один из самых читаемых сигналов в мониторинге, если история собрана.
ДискВсё сразу. Логи перестают писаться, база данных отказывает в записи, сессии обрываются, временные файлы не создаются - и причина невидима из собственных сообщений об ошибках приложения.Больше всего предупреждения из всех метрик, и его чаще всего упускают. Том, заполняющийся с постоянной скоростью, предсказуем за много дней.
Время подключенияЗависимость, на которую полагается сервер, стала медленной или недоступной, ещё до того, как это проявилось полным сбоем.Часто самый ранний сигнал о том, что что-то ниже по цепочке не в порядке.

Диск по праву заслуживает репутации классического предотвратимого простоя. Это тот единственный сбой, который монитор с порогом и недельной историей обязательно поймает первым, и тот, который потом сложнее всего объяснить.

Читайте тренд, а не только оповещение

Каждое показание сохраняется, поэтому у каждого серверного монитора есть собственный график значения во времени со средним, минимумом и максимумом за выбранный вами период. Проценты отображаются в процентах, а времена подключения - в миллисекундах, так что монитор CPU и монитор задержки базы данных воспринимаются каждый так, как вы ожидаете.

Оповещение говорит вам о том, что что-то пересекло черту; график говорит о двух вещах, которые вам на самом деле нужны дальше. Это новое? - всплеск, который выглядит тревожно в отрыве от контекста, часто оказывается тем же всплеском, что происходит каждый вторник в 02:00 уже год. И куда это движется? - показатель памяти, устойчиво растущий между перезапусками, - это утечка, каким бы ни было его текущее значение, а диск, растущий на два процента в неделю, имеет конкретную дату впереди.

Второй вопрос - это применение мониторинга сервера для планирования мощностей, и именно поэтому стоит начать собирать метрику раньше, чем вы решите, какой порог на неё поставить. Порог можно добавить через месяц, когда история уже покажет, как выглядит норма. История, которую вы не собрали, - это та, которую уже не вернуть.

Мониторинг сервера и мониторинг аптайма отвечают на разные вопросы

Это дополняющие друг друга инструменты, а не альтернативы, и это разделение достаточно чёткое, чтобы проговорить его прямо.

Мониторинг аптаймаМониторинг сервера
На какой вопрос отвечаетМожет ли посетитель прямо сейчас добраться до сайта?Достаточно ли здорова машина под ним, чтобы продолжать отвечать?
Откуда смотритСнаружи - 300+ чекпоинтов в 158 городахИзнутри - значение, считанное на самой машине
Типичный таймингСообщает в момент сбояСообщает до сбоя, если вы поставили порог до обрыва
Контроль ложных тревогПровалившееся наблюдение перепроверяется с других чекпоинтов и подтверждается кворумомОдно авторитетное показание, с счётчиком подряд идущих перегрузок в роли дебаунса
Замечает утечку памятиНет - пока это в итоге что-нибудь не обрушитДа - как тренд, за недели вперёд
Замечает сбой сетевого маршрута между вашими пользователями и вамиДаНет - с машиной всё в полном порядке

Использование только одного из них оставляет реальный пробел в каждую из сторон. Сочетание, на котором останавливается большинство аккаунтов, - это одноминутная проверка доступности из нескольких локаций плюс несколько серверных мониторов на CPU, память и том, который вероятнее всего заполнится.

Мониторинг по SNMP - для оборудования, которое никогда не запустит коллектор

Маршрутизаторы, коммутаторы, файрволы, ИБП и принтеры не могут разместить у себя скрипт, но почти все они уже умеют SNMP. Отдельная проверка SNMP считывает числовое значение прямо с устройства по OID - счётчики интерфейсов, температуру, нагрузку, аптайм, заряд батареи - через SNMP v1, v2c или v3, включая v3 с аутентификацией и шифрованием, так что учётные данные не передаются в открытом виде.

Если быть честными о том, где это находится сегодня: проверка SNMP считывает и записывает значение, которое сообщает устройство. Оповещение по порогу для значения SNMP пока недоступно - когда вам нужно, чтобы число реально порождало инцидент, используйте монитор нагрузки сервера через коллектор, у которого есть полная модель условий и дебаунса, описанная выше.

Настройка мониторинга сервера

  1. Решите, что раскрывать. Если на вашем сервере уже работает PHP или IIS, самый быстрый путь - подходящий готовый коллектор; в противном случае напишите конечную точку сами - она возвращает одно число.
  2. Разверните её на сервере, который хотите отслеживать, и убедитесь, что можете запросить её сами. Разместите её по непредсказуемому пути. Если машина новая, бесплатная проверка TCP-порта и бесплатный ping-тест - быстрый способ убедиться, что она доступна снаружи, прежде чем идти дальше; вход не требуется.
  3. Добавьте монитор типа Мониторинг CPU, RAM, HDD, выберите, какое значение он считывает, и укажите URL коллектора. Для монитора диска укажите путь или диск; для монитора времени подключения к базе данных - данные подключения, которые должен набирать коллектор.
  4. Задайте условие и лимиты - и осознанно настройте счётчик перегрузок до перехода в «недоступен», а не оставляйте его по умолчанию. Именно эта настройка решает, будет ли монитор полезным или его будут игнорировать.
  5. Выберите интервал - от одной минуты до 24 часов. Одна минута подходит для машины, на которой работает что-то бизнес-критичное; 5 или 10 минут вполне достаточно для тренда вроде использования диска.
  6. Повторите для каждого важного на этом хосте значения - CPU, память и том, который вероятнее всего заполнится, - разумный стартовый набор, - а затем добавьте контакты, которые должны об этом узнавать.
  7. Не настраивайте ничего в течение недели. Первая неделя истории покажет вам, правилен ли ваш порог, и это гораздо более надёжное доказательство, чем догадка, сделанная в первый день.

Ограничения, которые стоит знать

  • Коллектор должен быть доступен. Хост без какого-либо входящего доступа опросить нельзя. Раскрыть нужно одну доступную только для чтения ссылку, а не порт управления - но раскрыть её всё же придётся.
  • Один монитор следит за одним значением. CPU, память и диск - это три монитора, каждый со своим порогом и своей историей. Именно это делает оповещения точными, и это же значит, что загруженный сервер использует несколько слотов монитора.
  • Счётчикам производительности Windows нужен коллектор на ASP.NET. Тройка категория/имя/экземпляр считывается локально именно этим коллектором; хост на PHP вместо этого сообщает CPU, память, диск и времена подключения.
  • Нет подтверждения из нескольких локаций. В отличие от проверки доступности, серверная метрика поступает из одного авторитетного источника, поэтому единичное аномальное показание - это реальное показание. Именно для этого предназначен счётчик подряд идущих перегрузок, и его стоит настраивать.
  • Монитор сообщает то, что сообщает коллектор. Если в вашей собственной конечной точке есть ошибка, монитор добросовестно оповещает о неверном числе - именно поэтому важно опциональное поле ошибки в ответе: сообщайте об ошибке, а не о нуле.
  • Нет счётчика сетевой пропускной способности. Доступные значения - это CPU, память, использование диска, времена подключения и счётчики производительности Windows; пропускная способность среди них не значится. Для устройства, которое сообщает пропускную способность через SNMP, проверка SNMP может считать и построить график этого счётчика.

Часто задаваемые вопросы

Мониторинг сервера - это постоянное отслеживание ключевых показателей использования ресурсов вашего сервера: нагрузки CPU, использования RAM (оперативной памяти) и нагрузки HDD (диска), - чтобы видеть, как реально работает ваша инфраструктура, а не только то, отвечает ли сайт поверх неё. Мониторинг сервера от HostTracker проверяет эти три метрики и показывает тренды и всплески во времени, а это важно, потому что исчерпание ресурсов - одна из самых частых первопричин медленной работы, сбоев и полноценных простоев. Сервер может формально быть "доступен" и при этом находиться в шаге от отказа, если загрузка CPU зашкаливает, память почти исчерпана или места на диске критически мало - ничего из этого простая проверка доступности может не выявить, пока проблема действительно не приведёт к видимому сбою.

Сервер может оставаться доступным и формально онлайн, работая при этом опасно близко к пределу своих ресурсов, поэтому высокая загрузка CPU или RAM часто оказывается ранним предупреждающим признаком проблемы, а не самой проблемой. Устойчиво высокая нагрузка CPU замедляет обработку каждого запроса сервером, ухудшая опыт для всех посетителей, даже если сайт формально не падает полностью. Нехватка памяти ещё опаснее - по мере приближения использования RAM к пределу приложения могут начать падать, перезапускаться или принудительно завершаться операционной системой для освобождения памяти, что часто вызывает прерывистые, трудно диагностируемые сбои, похожие на случайные глюки, а не на явный отказ. Обнаружение повышенной загрузки CPU или RAM с помощью мониторинга сервера ещё до того, как это перерастёт в сбой, даёт администраторам время на расследование и заблаговременное увеличение мощностей.

Когда мониторинг CPU, RAM или дискового пространства обнаруживает необычную активность - устойчивый всплеск, приближение использования памяти к пределу или заканчивающееся место на диске, - HostTracker отправляет уведомление через любой из 9 настроенных каналов оповещений, включая email, SMS, голосовой звонок, webhook, Slack и мессенджеры вроде Telegram, Discord и Viber. Это значит, что ответственный за серверную инфраструктуру человек узнаёт о развивающейся проблеме с ресурсами напрямую, а не обнаруживает её только после того, как она уже вызвала замедление или сбой, замеченный клиентами. Поскольку отчёты и оповещения формируются автоматически на основе отслеживаемых данных, администраторы получают документированную историю трендов по ресурсам вместе с оповещением в реальном времени, что помогает отличить разовый всплеск от настоящей проблемы с мощностями, требующей долгосрочного решения.

Мониторинг аптайма отвечает на более узкий вопрос: доступен ли сайт или сервис и отвечает ли он прямо сейчас. Мониторинг сервера смотрит глубже, на саму инфраструктуру, на которой работает сайт - загрузку CPU, использование памяти и место на диске, - которые часто оказываются первопричиной сбоя аптайма, а не отдельной, не связанной с ним проблемой. Сервер, у которого заканчивается память или место на диске, ещё какое-то время может проходить проверку аптайма, прежде чем в итоге упадёт или замедлится до предела, поэтому если полагаться только на мониторинг аптайма, о проблеме вы узнаете, лишь когда она уже станет простоем. Сочетание обоих подходов даёт более полную картину: мониторинг аптайма подтверждает, что сайт доступен прямо сейчас, а мониторинг сервера отслеживает тренды по ресурсам, которые предсказывают, останется ли он таким и дальше.

Частота проверок настраивается под то, насколько быстро вам нужно узнавать о развивающейся проблеме с ресурсами. Платные тарифы HostTracker поддерживают интервалы мониторинга вплоть до раза в минуту, что полезно для серверов с бизнес-критичными приложениями, где всплеск нагрузки нужно заметить и устранить быстро. Менее критичные или менее нагруженные серверы могут использовать более длинный интервал, а постоянный бесплатный тариф проверяет два монитора каждые 30 минут - этого часто достаточно, чтобы заметить устойчивый тренд, например постепенное заполнение диска в течение нескольких дней, даже если очень кратковременный всплеск CPU при этом можно пропустить. 30-дневный пробный период с полным набором функций без привязки карты позволяет попробовать более быстрые интервалы проверки и увидеть, насколько детальными окажутся данные, прежде чем выбрать тариф.

Нет - устанавливать агент HostTracker не нужно, не нужен постоянно работающий демон и не нужно передавать никакие учётные данные. Проверка нагрузки сервера работает наоборот: ваш сервер открывает одну небольшую конечную точку, доступную только на чтение, которая сообщает одно число, а HostTracker запрашивает её по заданному вами расписанию. У вас есть три способа это предоставить. Два - это готовые скрипты-коллекторы, которые вы размещаете на уже работающем у вас сервере: один для PHP на Linux или Unix, другой для ASP.NET на IIS, - а третий способ - написать конечную точку самостоятельно, что занимает около десяти строк на любом языке: считайте значение как вам удобно и ответьте небольшим JSON-объектом с ним. Этот третий вариант многие команды предпочитают, потому что он гарантирует, что на их машине не выполняется ничего, что они не написали сами, и они точно контролируют, какие числа раскрываются наружу. Ничего никогда не отправляется на ваш сервер автоматически, и HostTracker никогда не открывает на нём сессию управления.

Конечная точка коллектора должна быть доступна для чекеров HostTracker, поэтому сервер за файрволом без какого-либо входящего доступа опросить напрямую нельзя. На практике это меньшее препятствие, чем кажется, потому что раскрыть нужно всего одну доступную только для чтения ссылку, возвращающую одно число, - не SSH, не порт управления, не протокол мониторинга. Обычно применяют такие подходы: публикуют конечную точку по непредсказуемому пути, ограничивают доступ к ней конкретными адресами, с которых она вызывается, или размещают её на машине в той же сети, которая уже доступна из интернета, и она сообщает данные от имени приватного хоста. Что бы вы ни выбрали, раскрываемая поверхность намеренно крошечная: конечная точка не принимает никаких команд, ничего не меняет и возвращает одно-единственное число. Это совершенно другой разговор о безопасности по сравнению с установкой стороннего агента с доступом на уровне системы, и именно поэтому проверка спроектирована именно так.

Мониторинг нагрузки сервера - проверки CPU, RAM и HDD - один из 13 типов проверок, доступных в продукте HostTracker, а постоянный бесплатный тариф позволяет бесплатно отслеживать два сервера или сайта с проверками каждые 30 минут. HostTracker в целом не является исключительно бесплатным продуктом - это платный сервис мониторинга с бесплатным уровнем в дополнение к нему, - поэтому бесплатный тариф хорошо подходит, чтобы попробовать мониторинг сервера на паре машин или как облегчённый вариант для небольших проектов, но не как основное предложение. Для мониторинга большего числа серверов, более коротких интервалов проверки или бизнес-критичной инфраструктуры, где важна более быстрая реакция, платные тарифы начинаются примерно от $5 в месяц, а 30-дневный пробный период с полным набором функций без привязки карты позволяет протестировать более быстрые интервалы перед принятием решения.

30 дней бесплатно без банковской карты

Не дайте перегрузке сервера застать вас врасплох

Начните бесплатный период и получайте оповещения, когда нагрузка CPU, RAM или диска превышает заданные пороги.

30 дней бесплатно - 100 мониторов - без банковской карты
  • Нам доверяют с 2004 года
  • 500 000+ отслеживаемых сайтов
  • 300+ контрольных точек по всему миру

Часть инструментов мониторинга сайтов HostTracker.